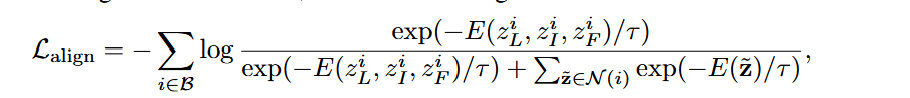<?xml version="1.0" encoding="UTF-8"?>
    <feed xmlns="http://www.w3.org/2005/Atom">
      <title>sorodo</title>
      <link href="/atom.xml" rel="self"/>
      <link href="/feed" rel="self"/>
      <link href="https://www.sorodo.xyz"/>
      <updated>2026-10-07T22:41:07.666Z</updated>
      <id>https://www.sorodo.xyz</id>
      <author>
        <name>sorodo猫娘</name>
      </author>
      <generator>Mix Space CMS</generator>
      <lastBuildDate>2026-10-07T22:41:07.666Z</lastBuildDate>
      <language>zh-CN</language>
      <image>
          <url>https://s3.bmp.ovh/imgs/2024/05/28/0d526b71da9a5101.jpg</url>
          <title>sorodo</title>
          <link>https://www.sorodo.xyz</link>
      </image>
        <entry>
            <title>missing finding</title>
            <link href='https://www.sorodo.xyz/notes/14'/>
            <id>https://www.sorodo.xyz/notes/14</id>
            <published>2026-09-19T18:21:56.157Z</published>
            <updated>null</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/notes/14'>https://www.sorodo.xyz/notes/14</a></blockquote>
<div><div><p>「心跳平稳，呼吸正常，贴~」</p><p>「滴——滴——」</p><p>「啊，试试这个」</p><p>猛然睁开眼，却发现筱泽広趴在我西装上扯着领带。</p><p>「筱泽同学，这是在做什么」</p><p>「在尝试唤醒制作人」</p><p>「你这个唤醒方式很特别」</p><p>筱泽広歪了歪头，俏皮地撤回座位。我才发觉自己正在电车上。</p><p>「啊，我睡了多久」</p><p>「很久呢，大概十年？」</p><p>「哼哼，你看起来可不像长大了十岁」</p><p>「这也是对偶像的赞美。」</p><p>归根结底，结束了忙了数天的外勤，结果筱泽広坚持说想回去路上坐一段时间电车，真是挺折腾我的身体的。其他的同事反而先坐自己专车回公司了。</p><p>「差不多到市区就该下了，如果不想被粉丝来个偶遇的话」</p><p>「安全，已经确认本车依旧是二人世界」</p><p>我看了看四周，确实可以说是空无一人的电车，窗外的风景也昭示着还在郊区。手表的指针指向十二点二十一分，我暗自会心一笑。</p><p>「制作人，要不要吃点午饭」筱泽広不知道从哪里突然变出两份三明治。</p><p>「列车上吃饭吗？虽然空无一人也是要注意在外形象的。」</p><p>「血糖...过低，要被饥饿消灭了」</p><p>我无奈接过三明治，陪她一起吃了起来。甚至筱泽広从来不需要担心体重管理，不如说，增点重更适合她的舞台活动保持体力，所以平常负责管理饮食的同事给出的就餐份量甚至比其他的小偶像还多出一点，与她的体重有鲜明的反差。</p><p>电车依旧咣当咣当地向前跑，平稳地没有什么波澜。我打开手机准备查找到站时间，结果筱泽広凑了过来挡住了我的视线。</p><p>「制作人，该好好吃饭」</p><p>「这次轮到你以牙还牙了」</p><p>「晕倒的可不是我」</p><p>「如果我是饿晕的话」</p><p>无视了诡辩，筱泽広一口气把三明治往我嘴里塞，虽然力气挺小的，但我也乖乖照做着吞咽。同时漂了一眼还亮着的手机屏幕，信号栏低得像水坝枯水期，不过确实也证实了我们还远远没到市区。</p><p>「哈有多油号安」我含着大三明治，本来想问还有多久到站，反而奇怪的发音让筱泽広呵呵呵地笑了起来。</p><p>「应该快了，醒了差不多就快到站了」说完，她晶莹剔透的双眼望向了窗外。我看着她的眼睛，看向深邃的眼眸中倒映着窗外飞驰向后的树影，看着，然后倒映着。</p><p>嗞嗞——</p><p>世界开始模糊起来，白色的泡泡包裹着一切。</p><p>滴——</p><p>「我又睡着了？」我猛然一把坐起，捂着自己头，疑惑确认着手表。</p><p>「是的，刚刚又昏睡过去了，嗯。。制作人这么累不应该拉制作人做电车的」筱泽広有点担心看着我。</p><p>手表指针依旧指向12时21分，我疑惑皱了皱眉，于是又打开手机比对了一下时间，但是对不上号，也许是手表没电了。</p><p>「下一站还有多久？」</p><p>「刚刚前面列车好像出了一些问题晚点了，现在我们车速也慢下来了」</p><p>我望向窗外，肉眼可见地能感知到行驶速度缓慢了不少，或者说，窗外风景在向前驶去。</p><p>「制作人，休息」</p><p>「筱泽同学，不要模仿我的语气说话」</p><p>筱泽広轻歪头望着我微笑。把前发撩拨到耳后，随即插起腰来。</p><p>「制作人，不要模仿我的样子逞强」</p><p>「赢不了你」</p><p>我摆摆手，然后插到脑后，闭上了双眼。</p><p>我做了一个梦。</p><p>梦里我和筱泽広正在准备参加一次盛大的演出，它是如此重要以至于我们为此准备了相当久。然而百密一疏的是，车在半路抛锚，此时正在会场堵车的路上不得不临时电车前往。然而突然地，一切骤然变为黑暗。</p><p>「広——」</p><p>「我在这里，我一直都在这里哦」広抱着我，抚摸我的背。</p><p>刚刚还有点惊慌的我很快感受到了平静。为什么惊慌，是电车和梦境很像？</p><p>「总觉得哪里不对」</p><p>「制作人，对広很严格，对电车，也很严格」</p><p>「对你可还不够严格」</p><p>「真鬼畜，制作人，喜欢」</p><p>筱泽広一通电波的发言反而把我拉回现实。仔细想想，演出之前一般我们都会提前很久或者前一天试音排演预备，不存在赶时间和堵车的情
况。所以梦境果然只是一个梦境。想到这里，我舒缓呼出一口气。</p><p>咔嚓——</p><p>「制作人，制作人，看镜头」</p><p>「不cheese」</p><p>「制作人笑起来明明很可爱的、来着」</p><p>「我可不是偶像」</p><p>我望向镜头，这是偶尔会单独给筱泽広拍照用的相机。虽然不知道她又从哪里凭空变出来的，但是也是承载了不少演出的回忆的物件，看着就让人很怀念。</p><p>不过，相机的时间好像不太对劲？</p><p>「怎么突然带这个？」</p><p>「怕你忘了，而且制作人还忘了手机」</p><p>我转身找自己的手机，但是发现手上拿着的手机其实是筱泽広的手机。</p><p>嗞嗞——</p><p>「可以了？」</p><p>「果然没那么简单，嗯...好痛苦...好开心」</p><p>嗞嗞——</p><p>「怎么回事」我扶着额头。</p><p>「又睡着了，制作人，今天身体不是很舒服？」</p><p>我看向自己手，刚刚拿的手机不见了。手表依旧停在12时21分。</p><p>不对劲，明明应该一开始就觉得不对劲的。</p><p>「我在做梦吗，现在几点了」</p><p>「并没有哦，広就在你面前哦，可以捏捏」</p><p>我伸手捏了捏她的脸，冰冰的，和盛夏的温度恰恰相反，但是恰好可以让我不太安静的心脏稍微冷静一点点。</p><p>「制作人看起来很惊慌」</p><p>筱泽広贴了近来。</p><p>「看起来很不安，是想到什么不好的事情了吗」</p><p>「总感觉，哪里不太对劲，比如，为什么我晕倒了这么多次，列车还没到站？」</p><p>「列车到站时间一直不都是很长吗？」筱泽広反问。</p><p>一直很长。很长吗。过去了多久呢，怎么感觉和常识不太一样呢。</p><p>「那筱泽同学预计一下，按平常来算一般还有多久下一站呢」</p><p>筱泽広的眼神突然恍惚了一下，又重新聚焦。</p><p>这个世界似乎也跟着眨了一下眼。</p><p>「到站吗，从没有到过站呢。」</p><p>「诶？」</p><p>震惊的瞬间，我缓过神来，筱泽広突然消失了。</p><p>我四处寻找，但却只是一个空无一人的列车。</p><p>「筱泽広！」</p><p>我大声呼叫，却没人回应。</p><p>我拉开隔厢的门，继续往前走，依旧空荡荡的车厢。</p><p>惊恐慢慢爬上我的后颈。我不敢放慢脚步，继续往前走着，拉开车厢门，走着——依旧空无一人。</p><p>这是哪里？刚刚发生的都是什么？我不敢多想，如果连列车头主控室都没有人的话，我大概是没救了吧。</p><p>最后一个车厢，或者说，车头。站着一位暹罗发色的少女，她倾国倾城的眼眸使得我在第一次看见她的时候，便下定决心要好好培养她。</p><p>「広，你在主控室这里是？」</p><p>「制作人太快了，还没准备好呢，有这么想我吗——呵呵」</p><p>「是啊，超级想你」我伸手去牵她的手。</p><p>然后手穿了过去。</p><p>不对——</p><p>「広！」我慌乱地呼喊她的名字，很快就得到了一个温暖的拥抱。</p><p>「怎么了，制作人，我就在这里哦」</p><p>筱泽広的手臂瘦瘦的，骨头卡着腰背并不是很舒服。我四下张望，发现我还坐在一开始的车厢。</p><p>「又，，睡着了吗？」我喃喃自语。</p><p>「是的呢，睡了好久——」</p><p>我看向手表，现在是12点31分。舒了一口气。</p><p>「制作人，制作人，来玩点猜谜游戏吧」</p><p>「可以啊，筱泽同学出题吗？」</p><p>「嗯嗯，是的哦，题目一——筱泽広的睡醒之后发现手表和睡着前指针指向同一个时间，但是手机时间却不对，是因为什么？」</p><p>「手表没电了？」</p><p>「题目二——平常专车提前前往live现场的筱泽広突然改坐电车，是因为什么？」</p><p>「诶？」</p><p>「题目三——列车似乎永远不到站，陪着制作人的筱泽広突然间——消失了，这是为什么？」</p><p>我瞪大了双眼，看着筱泽広，她的眼睛依旧神性，或者说，神。</p><p>「如果觉得很难回答的话，提示，倒着回答、哟」</p><p>「等等」</p><p>「不会很难的，制作人，努力想想脸颊也可以给你亲亲的」</p><p>我望向筱泽広，似乎亲一下也未尝不可。等等，我到底在想些什么？现在思维不论是混乱还是情绪变化都有点让我自己无法预测了。我深吸一口气冷静下来，开始重新思索筱泽広说的这些话。</p><p>倒着回答吗，也就是我回答题目一的手表没电是错误答案？可是我刚刚明明有手表没有电的回忆来着。仔细回想自己睡醒前的事情，却发现自己渐渐想不起来了，仿佛就是一个过去的梦境一般，雁过不留痕。那冷静地从第三题开始，刚刚的梦，消失的筱泽広，最后出现在了列车头的驾驶室。问题是面前的筱泽広是怎么知道我这个梦的？还是说我依旧在梦里？</p><p>「你，是真实的筱泽広吗？」</p><p>「上来就直切要害吗？真讨厌呢，制作人。——不过，问的很好，哟。我不是物理层面上的那个，筱泽広」</p><p>「但如果这个是梦境的话那也太过真实了一点。」</p><p>「那看来我做的还不错。」面前的这个「筱泽広」得意地叉腰。</p><p>「你依旧是刚刚驾驶舱的筱泽広，对吗？」</p><p>「不对。虽然题目不会很难，但也不会很简单」</p><p>「这些题目算是帮我搞清状况吗？」</p><p>「只是搞清状况的话，筱泽広没必要这样和制作人玩猜谜游戏的、哟」筱泽広继续俯身叉腰。</p><p>说真的，我几乎没什么能猜的线索，单论第三题，确实太过超自然了。如果不是同一个筱泽広，又同时知道我的这个梦，至少来说，筱泽広她自身在操控这个环境？或者说我在筱泽広神明的注视下？那也有点让人后脊发凉了。</p><p>「所以，这些场景是你控制的？」</p><p>「正解，啪叽啪叽，给制作人鼓掌，继续答对了可以奖励你哦」</p><p>「所以第三题，你既不是真实的筱泽広，又同时操控我这个梦境，也就是你作为筱泽広的意识侵入了我的意识，并篡改了我的梦境？」</p><p>「嗯嗯~嗯，严格来说不是篡改哦，很多内容也是你自己梦里本来就有的呢，或者说是你梦境期望出现的？」</p><p>「那真实的筱泽広在哪里」</p><p>她用一股怀念的眼神看着我，说着什么「很快就看得到，不如多陪陪——」然而这句话逐渐就像浸水了一般。我听得越来越模糊。</p><p>我仿佛掉入了冰冷的湖水里面，刺骨的水进入我的五脏六腑，想呼吸却无法呼吸。</p><p>「最好的机会，一次链接就能打通吗」</p><p>「筱泽広？」</p><p>我胡乱摆动双臂，试图触碰什么，冥冥中一道光线刺痛了我。一个温暖的手拉住我疯狂抽离湖面。</p><p>「広——哈啊，哈啊」我留着冷汗再度苏醒。</p><p>「即便在梦里都这么想念我吗，哼哼，制作人，H。——那，试着回答第二题、呢？」</p><p>如果是筱泽広这么说的话，那么第二题应该和真实的筱泽広有关，电车，吗？确实是一个反常项。一般都是我直接开车接送，也会提前很久在会场排练，所以不存在堵车的困扰，且为了避开公共场合，也不会做电车这种公共交通出行。但是，如果有那么一种极端情况要做电车，不如说就像刚刚的梦中梦？</p><p>半路抛锚，但是一般也是提前去演出点，所以可以打车或者联系同事。也就是在演出之后？且比较赶时间的样子，在人流量大的散场时间回去拿东西，那究竟是什么这么着急呢？</p><p>「制作人制作人，cheese——」</p><p>突然的闪光，我想起来了什么。</p><p>「所以我刚刚梦里，或者说梦中梦的内容是真的。只不过是在演出结束之后，我们想拿的是这个相机，就像例行演出结束之后拍照纪念，所以因为抛锚急匆匆坐的电车回去」</p><p>「嗯，所以接下来继续回答的话，会慢慢接触到一些残酷的事实呢」</p><p>「所以电车出事了」</p><p>「嗯」</p><p>我不敢乱想，只能颤颤巍巍问出最后的问题。</p><p>「所以，你只是筱泽広留下来的意识，或者说程序？而我，在梦境里面逃避？」</p><p>「嗯，嗯，我确实是一串代码组成的呢。不过，是不是还有一个问题还没有回答」</p><p>「这一切还有回答的必要了，吗」</p><p>「回答奖励亲亲」</p><p>「搞不明白你这个程序」</p><p>「啊，程序也会伤心的，再怎么说我也是复制的筱泽広的人格」</p><p>我又在无奈中获得短暂的冷静。手表停止，手机正常，不是手表没电还能是什么情况？感觉她在诱导我思考什么奇怪的问题。</p><p>「有没有可能，手表是你的，手机是我的」她突然开口提示。</p><p>我错愕了一会，然后想起来了什么。那天紧急在电车上，我慌乱中想找手机，却发现没有。</p><p>「第一题很难呢，让筱泽広帮你回答吧，——因为暂时停下脚步的，是制作人啊」</p><p>「嗯？」</p><p>「制作人，仔细想想吧，以制作人的能力，是不可能做到侵入意识的。留下代码的是筱泽広，创造我的也是筱泽広，能够做到脑机修改意识梦境来唤醒制作人的，也只有本尊这位天才少女了呢」</p><p>「三道题目，筱泽広应该换成制作人，就全对了呢，是制作人的手表（时间）停止了，制作人在坐电车，制作人的电车永远没有到站，消失了」</p><p>我发现这个程序编撰的筱泽広眼里噙着泪花。我伸出手，想要触碰她，然而却在触碰的一瞬间失去了意识。</p><p>——</p><p>死寂的黑暗。</p><p>我回想起来，就续在之前的梦境，那个盛大的演唱會，颠三倒四的我为了最好的演出效果加了不少班，叮嘱了导播，处理了人事，制定好了一切周密的计划，然而百密一疏的是，去排演的路上却忘记了平常一直要带的那个照相机——一直专心工作的话，总会忘记自己生活中最闪闪发光的东西。「这么重要的场合，这个更不能忘了拿」这么想着，在演出时候准备开车回去拿相机，这样结束之后留下一两张照片的，这个样子。可我高估了自己的精神力，车辆抛锚，手机也忘了带身上，急匆匆地走也没有车能打，路上已经堵得水泄不通，不得已只能坐电车，然后，最不逢时的是，攥着扶手焦急等待的时候，电车在一段急刹和剧烈摇晃中，我也失去了意识。</p><p>「鬼畜，狡猾，真不公平，我还想多呆一会，啊啊，但是设定上来说我只是来唤醒你的程序呢」</p><p>我又醒了，但是这次不是在电车上，而是一个白色的病床，我身上插满了各种电极，甚至是侵入式的电极。同时有一团暹罗发色的女生趴在我身上。</p><p>「唤醒制作人，比做偶像还困难，呢。但是过去了这么久，总算，成功了。」她头埋在被子里喃喃到。</p><p>我抬起手，想摸她的头，手指却先碰到了自己脸上的湿痕。什么时候开始的，不知道。她抬起头，眼睛红红的，却还在笑。</p><p>「制作人，欢迎回来。」</p><p>窗外，雪花初融，光，是暖的。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/notes/14#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>具身学习005：视觉与运动关联-EgoWAM，UDVLA，VS</title>
            <link href='https://www.sorodo.xyz/posts/embody-ai/act-vis'/>
            <id>https://www.sorodo.xyz/posts/embody-ai/act-vis</id>
            <published>2026-09-17T08:35:35.100Z</published>
            <updated>null</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/embody-ai/act-vis'>https://www.sorodo.xyz/posts/embody-ai/act-vis</a></blockquote>
<div><div><h3 id="前言">前言</h3><p>读点小众的。。</p><p><a href="https://arxiv.org/abs/2607.08436">EgoWAM</a></p><p><a href="https://github.com/OpenHelix-Team/Unified-Diffusion-VLA">UDVLA</a></p><p>话说居然是首个开源的扩散VLA。。我们VLA社区还是太有开源精神了。</p><h3 id="egowam">EgoWAM</h3><p><strong>具身鸿沟与共享表示问题</strong></p><p>当模型在人类和机器人演示数据上进行联合训练时，它通常采用一个共享骨干网络从视觉输入中提取特征。在标准的BC联合训练中，模型使用这些特征来预测人类数据集 $D_H$ 和机器人数据集 $D_R$ 的下一个动作。</p><p>问题在于共享特征与特定的具身（embodiment）纠缠在一起。例如，人类可能会用精细的手指动作抓取一个杯子，而机器人则使用平行爪夹。如果模型仅通过动作解码器学习，它将难以将意图（移动杯子）与执行（人类手指与机器人夹爪）区分开来。</p><p>世界动作模型（WAMs）提供了第二个监督通道。通过要求模型在某个时间范围 TTT 内预测未来状态 st+Ts_{t+T}st+T​，骨干网络被迫学习描述物体动态和场景演变的特征。因为物理定律——例如杯子在桌子上滑动的方式——无论是人类还是机器人推动，都是相同的，所以这个世界模型信号充当了一个弥合具身鸿沟的“传输接口”。</p><h3 id="udvla">UDVLA</h3><p>UD-VLA最核心的价值在于它解决了传统VLA模型中视觉生成与动作预测脱节的问题。通过单一的Transformer架构和联合离散去噪扩散过程（JD3P），模型能够在相同的去噪步骤中并行生成未来图像和动作指令，使得动作规划能够在持续演变的视觉指导下进行迭代细化。</p><p>对比RTC或者DCDP之类的思想来说，UDVLA直接改造 VLA 本体，让“预测未来视觉状态”和“生成 action chunk”在同一个离散扩散过程中共同迭代。</p><p>UD-VLA 作者认为对比传统的ACT来说，这里缺了一层很有价值的中间推理：</p><p>$$ </p><p>\boxed{ \text{Current Observation} \rightarrow \text{Future Visual State} \rightarrow \text{Action} } </p><p>$$</p><p>也就是说，与其让模型直接猜“应该怎么动”，不如先隐式回答：</p><p>如果任务正确完成，接下来世界应该变成什么样？</p><p>然后 action prediction 就更像一个 inverse dynamics 问题：</p><p>$$ </p><p>(o<em>t,\hat o</em>{t+\Delta}) \rightarrow A_t </p><p>$$</p><p>这类思想不是 UD-VLA 第一次提出；WorldVLA、UniVLA、CoT-VLA、F1、UP-VLA 等都在利用 future visual prediction。但是作者认为已有方法有两个问题：一些方法用额外 vision/image/action expert，视觉生成和 action 生成仍然模块化分离；另一些虽然统一了 token space，却仍然先后或独立生成 image/action，导致 future visual information 对 action 的影响不够充分。</p><p><strong>核心方法</strong></p><p>action token 和 visual token同时去噪。这个diffusion来说和图像的高斯还不一样，接近Langrage的diffusion，直接对tokens加mask。</p><p>72 轮 diffusion</p><pre><code>Emu3 multimodal autoregressive Transformer
              │
              ▼
world-model post-training
              │
              ▼
convert decoding/training toward
discrete diffusion + hybrid attention
              │
              ▼
JD3P robot fine-tuning</code></pre><p>foresight-driven。。嗯，力大砖飞</p><h3 id="vs-视觉伺服控制">VS 视觉伺服控制</h3><p>这个是比较基础的概念，在这个时代不知道还用不用的到..先说说伺服控制的词意思：<strong>闭环反馈系统</strong>精确控制执行机构的位置、速度和转矩，实现高精度运动控制</p><p>视觉伺服控制是指利用计算机视觉数据来控制机器人的运动。在这种情况下，机器人的运动引起视觉伺服控制是指利用计算机视觉数据来控制机器人的运动。相机运动，或者相机可以固定在工作空间中，以便它可以从静止配置观察机器人运动。</p><p>典型的来说——</p><p>计算<strong><em>当前视觉特征−目标视觉特征</em></strong></p><p>然后误差转换成机械臂的移动增量。也就是，让期望的目标视觉特征趋近于0。</p><p>关于路线则分为两派——PBVS（Position-Based Visual Servoing）&amp; IBVS（Image-Based Visual Servoing）</p><h4 id="pbvs">PBVS</h4><p>核心思想：先从图像恢复目标的三维位姿，再在 3D 空间控制机器人。</p><p>运动比较符合人的三维和物理直觉。</p><p>image -&gt; position estimation -&gt; 3D error -&gt; motion</p><p>然而做过SLAM的知道，视觉直接估计准确的 Position estimation 是一个难题。标定，PnP，深度估计任何误差都对其有影响。</p><h4 id="ibvs">IBVS</h4><p>为什么一定要把目标三维坐标精确算出来？直接计算(u,v)→(u∗,v∗)，在图像空间进行估计即可。（正常人在抓个手机时候也不至于先估计好自己手和手机的三维坐标再解算）</p><p>Image→Image Features→Image Error→Camera Velocity</p><p>不过需要解算的是相机的移动怎么转化为图像的移动？这里公式倒是很多，不过还是SLAM的老一套空间解算了。懒得写笔记了</p><p>来看看核心的转化矩阵：</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/17/w07LEoyR.png"/></p><p>这里的Z依旧是相机光心。平移部分有Z，旋转部分无Z。诶，所以这几个自由度还能分别解算。</p><p>整个流程差不多是：</p><pre><code>              3D point
             P=(X,Y,Z)
                  │
                  │ Perspective projection
                  ▼
             image point
              s=(x,y)
                  │
                  │ compare
                  ▼
        e = s - s*
                  │
                  │ Desired dynamics
                  │ ė = -λe
                  ▼
      ┌────────────────────┐
      │ Interaction Matrix │
      │      ṡ = L v       │
      └────────────────────┘
                  │
                  │ inverse / pseudoinverse
                  ▼
           v = -λ L⁺ e
                  │
                  ▼
            Camera moves
                  │
                  ▼
          Feature moves
                  │
                  └──────────────┐
                                 │
                           next image</code></pre><p>对于VLA当然不是eye in hand了。但是同样我们需要的是机械臂-&gt;目标物的Loss坐标，原文的相机运动引发目标运动的公式变成关节运动在视觉空间里面特征怎么运动。</p><p>值得一提的是各种图像的特征确实，信息不足等都可能导致Jacobian不可逆然后velocity爆炸啊。有一些Damped Least Squares之类的的方法优化一下这一套数学模型。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/embody-ai/act-vis#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>具身学习004：ACT、RTC、Proprio、DCDP</title>
            <link href='https://www.sorodo.xyz/posts/embody-ai/act-proprio'/>
            <id>https://www.sorodo.xyz/posts/embody-ai/act-proprio</id>
            <published>2026-09-15T08:27:55.311Z</published>
            <updated>2026-09-15T14:09:52.225Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/embody-ai/act-proprio'>https://www.sorodo.xyz/posts/embody-ai/act-proprio</a></blockquote>
<div><div><h3 id="前言">前言</h3><p><a href="https://arxiv.org/abs/2304.13705">ACT：Learning Fine-Grained Bimanual Manipulation with  Low-Cost Hardware</a></p><p><a href="https://blog.csdn.net/nenchoumi3119/article/details/147504821">VLA 论文精读（十九）Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware</a></p><p><a href="https://arxiv.org/abs/2608.03052">Proprio：How Should Vision-Language-Action Models Use Proprioceptive State?</a></p><p><a href="https://arxiv.org/abs/2603.01953">DCDP：Closed-Loop Action Chunks with Dynamic Corrections for Training-Free Diffusion Policy</a></p><p><a href="https://github.com/wupengyuan/dcdp">DCDP-Github</a></p><p>属于是越读越基础来了。</p><h3 id="act">ACT</h3><p>摘要：Learning 能否让低成本且非高进度硬件执行这些精细操作任务是一个问题。</p><p>人类也不具备工业级的精确本体感知，但我们能够通过学习闭环视觉反馈并主动补偿误差来执行精细的任务。因此，在系统中作者训练了一种端到端策略，将商用网络摄像头的 RGB 图像直接映射到动作上。</p><p>回顾action chunking——该概念描述了如何将一系列动作组合成一个组块，并作为一个单元执行。该策略会预测接下来 k 个时间步的目标关节位置，而不是一次只预测一步。这将任务的有效范围缩小了 k 倍，从而减轻了复合误差。预测动作序列还有助于解决时间相关的混杂因素，例如演示中的停顿，而这些停顿很难用马尔可夫单步策略建模。</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/15/viZZUaZ9.png"/></p><p>动作生成是使用 transformer 实现 CVAE encoder和decoder。</p><p>然后给这上面一组动作块加了一个指数衰减的时序的权重取值，最近输出的act的权重最高。</p><p>核心思想就是动作分块+时序。</p><h3 id="rtc">RTC</h3><p>加上这一后篇RTC：Training-Time Action Conditioning for Efficient  Real-Time Chunking</p><p>后补：看到一个写的巨好的博客：<a href="https://blog.csdn.net/v_JULY_v/article/details/155892713">Training-Time RTC——在训练时模拟推理延迟</a></p><p> 还有前身RTC：<a href="https://blog.csdn.net/v_JULY_v/article/details/149352338">实时动作分块RTC——为解决高延迟，让π0.5也可以点燃火柴、插入网线：执行当前动作分块时生成下一个分块，且已执行的冻结并通过“图像修复”引导新块的生成</a></p><p>临时写这个的解析，刚刚好是ACT的补充。先看看其面对的问题背景：</p><p><strong>Real-time chunking (RTC) presents an approach to this problem that combines action chunking, flow matching, and inference-time inpainting</strong></p><p>简单来说，原版的ACT用的CVAE，而后续很多改进都用的flow matching；但是就算是flow matching生成速度也不够实时——VLA的一生都在和延迟、算力、实时性搏斗。</p><p>RTC同时融了通过融合动作分块、流匹配和推理时动作修复；这个文章增加了延迟的考虑（RTC的延迟补丁）</p><h4 id="方法论">方法论</h4><p>首先是RTC，采用异步分块来融合上三者问题：</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/15/4355ZOAz.png"/></p><p>一看到就想起之前的pi-R2，所以这些路径确实是一脉相承。不过RTC这里还在用指数衰减的时间权重处理未来动作块阶段。</p><p>至于后片的training time RTC，则给了RTC的训练方法。</p><p>该方法不要在推理时修补动作，而在训练时就教会模型应对延迟——直接在训练阶段，模拟推理延迟。</p><p>直接把“前缀动作”(即推理期间机器人已经执行掉的动作)作为已知条件喂给模型，让模型只负责预测剩下的“后缀动作”</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/15/dgjSZvwb.png"/></p><p>关于代码和具体设计快速执行的部分以后有时间再补。</p><h3 id="proprio">proprio</h3><p>这是关于VLA如何高效利用机器人本体感觉状态（Proprioceptive State）的研究论文。</p><p>为了排除模型架构、训练数据和动作表示的干扰，论文建立了一个统一的、受控的实验框架（基于$\pi_{0.5}$模型和Flow-Matching专家架构），将状态设计作为唯一变量：</p><p>五种接口设计：</p><pre><code>State Prompt (sp)：将状态量化为离散文本标记。
VLM Prefix (vp)：将状态投影为连续嵌入（embedding）插入VLM前缀。
Action Prefix (ap)：将状态嵌入置于动作后缀，直接参与动作预测。
State Expert (se)：引入独立的Transformer分支处理状态。
Feature Modulation (fm)：通过跨注意力机制对动作特征进行尺度（scale）和偏移（shift）调制。</code></pre><p>控制变量实验：利用45个原子任务（分为搬运、交互、精密操作三类）和20个复合任务进行评估。通过“Slot-Matched Repeat-Current Control”实验（将历史帧替换为重复的当前帧），剔除容量干扰，验证时序信息的真实价值。</p><h4 id="关键发现与设计准则">关键发现与设计准则</h4><p>这个论文主要考虑的是动作注入的原则——所以结论有利于我们参考动作回环设计。</p><p>研究通过受控实验得出了系统性的结论：</p><ul><li><p>状态效用与接口：本体感觉状态能提升闭环控制性能，但不存在万能接口。离散提示（sp）在搬运任务中表现最优，而连续接口（vp, se, fm）在交互和精密任务中优势明显。</p></li><li><p>时序历史的作用：状态历史存在“有限收益区间”。实验表明，8帧左右的短历史序列是最优平衡点，过长的历史不仅无法提升性能，反而会因冗余信息干扰动作预测。Slot-matched实验证实，性能提升源于状态的有序时序演变。</p></li><li><p>注入位置的切换：存在一个明确的注入原则：</p></li></ul><pre><code>单帧状态：注入VLM侧（即VLM Prefix）效果更佳。
多帧历史：注入动作侧（即Action Prefix）效果更佳。
该发现被证实对不同的状态表示（位姿 vs. 关节角）具有鲁棒性。</code></pre><h3 id="dcdp">DCDP</h3><p>这个新一点。同样是开环动作问题：执行一半环境变化了咋搞。闭环控制则需要对每一步进行运动的矫正。但是实际开销很大：每次调用DP都接近于一个完整的chunk开销，实际单步运算效率十分低下。</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/15/B2DMkqlt.png"/></p><p>用论文的数据可以得到单步执行速率对比：</p><table><thead><tr><th>方法</th><th style="text-align:right">平均单步计算延迟</th></tr></thead><tbody><tr><td>Open-Loop (H=8)</td><td style="text-align:right">7.05 ms</td></tr><tr><td>Closed-Loop (H=1)</td><td style="text-align:right">53.60 ms</td></tr><tr><td>Temporal Ensemble</td><td style="text-align:right">53.74 ms</td></tr><tr><td><strong>DCDP (H=8)</strong></td><td style="text-align:right"><strong>7.39 ms</strong></td></tr></tbody></table><p>其思想是保留开环DP的同时对DP每一个动作微调。</p><p>其给出了一个Dynamics Extractor + Asymmetric VAE，不需要训练原先的DP，实现对运动的纠正。</p><pre><code>                 Slow path
Current Obs ───&gt; Diffusion Policy
                      │
                      ▼
          planned action chunk A
                      │
                      ▼
                 VAE Encoder
                      │
                      ▼
                  latent z
                      │
                      │
               ┌──────┴──────┐
               │             │
               │ Fast path   │
               │             │
recent images ─────&gt; Dynamics Extractor
                           │
                           ▼
                     dynamic F_t
                           │
                 ┌─────────┘
                 ▼
         Dynamic VAE Decoder
                 │
                 ▼
           corrected action</code></pre><p>也就是slow部分压到VAE的z空间——fast部分反复多次调用利用recent image条件调整z的生成（解码）。</p><p>其把原 Diffusion Policy 的 action chunk 压缩成一个 plan latent。再进行解码。也就是实际动作生成的后半段用的是论文自己的DCDP，并不是单纯的模块化插入，要固定原生的DP一起训练。</p><h4 id="dynamic-feature-extractor">Dynamic Feature Extractor</h4><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/15/xWrZz12b.png"/></p><p>首先是判断环境的改变问题。</p><p>这里直接先输入最近的5帧图像。ResNet18 提取个特征。同时，相邻帧在ResNet的特征空间直接作差（类比帧差的思想，这里是提取其动目标）得到D并与时序的特征交叉自注意力提取值得关注的帧间变化（也就是值得关注的特征 x 帧间差变化明显的特征）输出F，且还要F拟合这个D的分布（也就是要求你这个 feature 必须真的和“场景最近发生了什么变化”有关）。</p><p>至于时序的注意力则是transformer则直接把5帧内容按照时序顺序塞进去提取运动的趋势变化。都如上图stage1所示。</p><h4 id="asymmetric-vae">Asymmetric VAE</h4><p>这里固定了push-T的4个action。</p><p>这里 latent 倒是只有2维。由原生DP输出的动作序列压缩得到，但是解码过程则有z和前面动态视觉特征提取器得到的抽象特征F。类似条件VAE等等。(PS.论文还加了步长的条件，然而实际上其代码我没有翻到)</p><h4 id="论文实验环境">论文实验环境</h4><p>Push-T，非常轻量的 2D manipulation benchmark。目标是圆形 agent 把一个 T 型刚体推到目标 T 区域。是是非常简化的 manipulation control 问题。没想到这样也可以拉出来验证。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/embody-ai/act-proprio#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>具身学习003：OpenVLA与SIMPLE，开源VLA与仿真平台</title>
            <link href='https://www.sorodo.xyz/posts/embody-ai/openvla-simple'/>
            <id>https://www.sorodo.xyz/posts/embody-ai/openvla-simple</id>
            <published>2026-09-11T18:07:17.193Z</published>
            <updated>null</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/embody-ai/openvla-simple'>https://www.sorodo.xyz/posts/embody-ai/openvla-simple</a></blockquote>
<div><div><h3 id="前言">前言</h3><p>大悲伤，写完忘记保存了。这次干脆写点新的啊。。</p><p>OpenVLA：<a href="https://github.com/openvla/openvla.git">https://github.com/openvla/openvla.git</a></p><p>SIMPLE：<a href="https://github.com/physical-superintelligence-lab/SIMPLE">https://github.com/physical-superintelligence-lab/SIMPLE</a></p><h3 id="总结">总结</h3><p>关于这两者的论文其实放现在也不算什么前沿。</p><p>关于OpenVLA，依旧是我们的V+L+A——视觉检测头SigLIP加上一个多层感知机连接到LLM，然后接上一个动作头。</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/09/fgVjR1LC.png"/></p><p>之前本来写了还吐槽包括使用了Dino等各种其他的头来增加稳定性和准确性等，不过现在的VLA设计更多在动作头上开刀做文章，LLM选取当中，千问的小模型莫名还挺受欢迎？这里OpenVLA反正用的是Llama 2 7B的模型。</p><p>而SIMPLE就是在NVIDIA的Issac Sim上换了一个新的开源刚体物理计算的包：</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/10/s9kcQ2li.png"/></p><p>这两个可以用于测试算法和仿真构建，试试自己的一些idea啊。</p><h2 id="simple-+-openvla-实验环境搭建指南">SIMPLE + OpenVLA 实验环境搭建指南</h2><p>采用的是 <strong>SIMPLE（physical-superintelligence-lab/SIMPLE）作为仿真平台 + OpenVLA-7B 作为待验证策略</strong>，先跑官方已经接好的 <strong>FrankaTabletopGrasp-v0</strong>，目标先验证完整链路：</p><p><strong>SIMPLE → RGB Observation + Language Instruction → OpenVLA → 7-DoF Action → SIMPLE 执行动作 → Success / Failure</strong></p><p>SIMPLE 官方目前确实已经提供 <code>FrankaTabletopGrasp-v0 + openvla</code> 的评测入口。(<a href="https://github.com/physical-superintelligence-lab/SIMPLE/blob/main/docs/source/tutorials/eval.md?utm_source=chatgpt.com" title="SIMPLE/docs/source/tutorials/eval.md at main · physical-superintelligence-lab/SIMPLE · GitHub">GitHub</a>)</p><h3 id="实验目标">实验目标</h3><p>搭建一个用于具身智能 / Vision-Language-Action 模型验证的基础实验环境：</p><ul><li>仿真平台：<strong>SIMPLE</strong></li><li>机器人：<strong>Franka</strong></li><li>基础任务：<code>FrankaTabletopGrasp-v0</code></li><li>VLA：<strong>OpenVLA-7B</strong></li><li>操作系统：Ubuntu 22.04</li><li>推理方式：OpenVLA 独立 HTTP Server</li><li>仿真方式：SIMPLE Client</li><li>渲染：headless / EGL</li><li>初期目标：跑通单个闭环 episode</li></ul><p>整个系统建议拆成两个独立进程：</p><pre><code class="lang-text">┌──────────────────────────────┐
│        OpenVLA Server        │
│                              │
│ RGB Image                    │
│ Language Instruction         │
│         ↓                    │
│     OpenVLA-7B               │
│         ↓                    │
│  7-DoF Robot Action          │
└─────────────┬────────────────┘
              │ HTTP
              │ /act
              ▼
┌──────────────────────────────┐
│        SIMPLE Client         │
│                              │
│ Isaac Sim / MuJoCo           │
│        Franka                │
│         ↓ ↑                  │
│ Observation ↔ Action         │
│         ↓                    │
│ Success / Failure            │
└──────────────────────────────┘</code></pre><p>建议<strong>不要把 SIMPLE 与 OpenVLA 安装在同一个 Python 环境里</strong>。</p><p>PS：</p><ul><li><p>SIMPLE 包含 Isaac Sim、MuJoCo、CuRobo、LeRobot 等大量依赖；</p></li><li><p>OpenVLA 对 PyTorch、Transformers、Timm、Tokenizers 等版本有自己的约束；</p></li><li><p>两套环境通过 HTTP 通信，本来就没有必要共用依赖；</p></li><li><p>后续更换 π0、π0.5、ACT、Diffusion Policy 等模型时，可以直接替换 Policy Server。</p></li></ul><hr/><h3 id="推荐配置">推荐配置</h3><p>推荐：</p><pre><code class="lang-text">Ubuntu:       22.04 LTS
CPU:          12 核以上
RAM:          64 GB
GPU:          NVIDIA RTX 3090 / 4090 或更高
VRAM:         24 GB 推荐
NVIDIA Driver: 新版驱动
CUDA Toolkit: 12.4 推荐
Python:       3.10
SSD:          至少 100 GB 空闲</code></pre><p>SIMPLE 基于 Isaac Sim 4.5 和 MuJoCo 3.3，官方要求 Ubuntu 22.04 与 RTX 级 NVIDIA GPU；官方文档测试过 CUDA 11.8 和 CUDA 12.4。(<a href="https://github.com/physical-superintelligence-lab/SIMPLE/blob/main/README.md" title="SIMPLE/README.md at main · physical-superintelligence-lab/SIMPLE · GitHub">GitHub</a>)</p><p>如果有两张 GPU，推荐：</p><pre><code class="lang-text">GPU 0 → SIMPLE / Isaac Sim
GPU 1 → OpenVLA</code></pre><p>因为 OpenVLA-7B 本身会占用较多显存，而 Isaac Sim 同样是重 GPU 应用。SIMPLE 官方甚至建议条件允许时，把 VLA Server 放到另一台机器。(<a href="https://github.com/physical-superintelligence-lab/SIMPLE/blob/main/docs/source/tutorials/eval.md?utm_source=chatgpt.com" title="SIMPLE/docs/source/tutorials/eval.md at main · physical-superintelligence-lab/SIMPLE · GitHub">GitHub</a>)</p><h3 id="安装基础依赖">安装基础依赖</h3><p>CUDA就懒得赘述了，不同机器的CUDA都不太一样。</p><pre><code class="lang-bash">sudo apt update

sudo apt install -y \
    git \
    git-lfs \
    curl \
    wget \
    unzip \
    build-essential \
    cmake \
    python3-dev \
    ffmpeg \
    gstreamer1.0-libav</code></pre><p>初始化 Git LFS：</p><pre><code class="lang-bash">git lfs install</code></pre><p>检查：</p><pre><code class="lang-bash">git --version
git lfs version
cmake --version</code></pre><h4 id="安装-simple">安装 SIMPLE</h4><p>建议目录：</p><pre><code class="lang-bash">mkdir -p ~/robotics
cd ~/robotics</code></pre><p>克隆：</p><pre><code class="lang-bash">git clone https://github.com/physical-superintelligence-lab/SIMPLE.git
cd SIMPLE</code></pre><p>如果 SSH GitHub 已配置，也可以：</p><pre><code class="lang-bash">git clone git@github.com:physical-superintelligence-lab/SIMPLE.git</code></pre><p>拉取子模块：</p><pre><code class="lang-bash">git submodule update --init --recursive</code></pre><p>官方 SIMPLE 本身也要求完整初始化 submodules。(<a href="https://github.com/physical-superintelligence-lab/SIMPLE/blob/main/README.md" title="SIMPLE/README.md at main · physical-superintelligence-lab/SIMPLE · GitHub">GitHub</a>)</p><hr/><h4 id="安装-uv">安装 uv</h4><p>SIMPLE 当前官方推荐优先使用 <code>uv</code>。虽然我知道你喜欢conda，但是你先别急。。</p><pre><code class="lang-bash">curl -LsSf https://astral.sh/uv/install.sh | sh</code></pre><p>重新载入 shell：</p><pre><code class="lang-bash">source ~/.bashrc</code></pre><p>确认：</p><pre><code class="lang-bash">uv --version</code></pre><h4 id="创建-simple-环境">创建 SIMPLE 环境</h4><p>uv来说确实没conda那么熟悉，顺便补充uv的虚拟环境</p><p>在：</p><pre><code class="lang-bash">cd ~/robotics/SIMPLE</code></pre><p>执行：</p><pre><code class="lang-bash">UV_HTTP_TIMEOUT=3000 \
GIT_LFS_SKIP_SMUDGE=1 \
uv sync --all-groups --index-strategy unsafe-best-match</code></pre><p>SIMPLE 会在项目目录产生：</p><pre><code class="lang-text">SIMPLE/
└── .venv/</code></pre><p>然后：</p><pre><code class="lang-bash">source .venv/bin/activate</code></pre><hr/><h4 id="安装-curobo">安装 CuRobo</h4><p>CuRobo 目前仍然属于 SIMPLE 的必需依赖。</p><p>对于 RTX 4090，compute capability 为 8.9，可以提前设置：</p><pre><code class="lang-bash">export TORCH_CUDA_ARCH_LIST=8.9+PTX</code></pre><p>然后：</p><pre><code class="lang-bash">bash scripts/install_curobo.sh</code></pre><p>官方文档也专门推荐针对 4090 使用：</p><pre><code class="lang-bash">export TORCH_CUDA_ARCH_LIST=8.9+PTX</code></pre><p>避免为大量不相关架构编译 CUDA kernel。(<a href="https://psi-lab.ai/SIMPLE/docs/tutorials/installation.html?utm_source=chatgpt.com" title="Installation - SIMPLE documentation">物理超智能实验室</a>)</p><h3 id="验证安装">验证安装</h3><p>首先：</p><pre><code class="lang-bash">source ~/robotics/SIMPLE/.venv/bin/activate</code></pre><p>验证 Python package：</p><pre><code class="lang-bash">python -c &quot;import simple; print(simple.__version__)&quot;</code></pre><p>如果成功，会输出 SIMPLE 版本。</p><p>进一步查看任务：</p><pre><code class="lang-bash">python scripts/list_env.py</code></pre><p>SIMPLE 官方也将这一步作为基本安装测试。(<a href="https://psi-lab.ai/SIMPLE/docs/tutorials/installation.html?utm_source=chatgpt.com" title="Installation - SIMPLE documentation">物理超智能实验室</a>)</p><h4 id="第一次启动-isaac-sim">第一次启动 Isaac Sim</h4><p>第一次运行 Isaac Sim 通常明显比之后慢。</p><p>推荐先：</p><pre><code class="lang-bash">export ACCEPT_EULA=Y
export OMNI_KIT_ACCEPT_EULA=YES</code></pre><p>然后测试一个 SIMPLE/CuRobo 示例：</p><pre><code class="lang-bash">python examples/multi_arm_reacher.py</code></pre><p>如果机器没有显示器，后面统一使用 headless 模式即可。</p><p>如果出现 Vulkan / NVIDIA library 问题，可以先检查：</p><pre><code class="lang-bash">sudo apt install -y vulkan-tools

vulkaninfo --summary</code></pre><p>正常情况下应能看到 NVIDIA GPU。</p><hr/><h3 id="openvla-环境">OpenVLA 环境</h3><p>接下来<strong>新开一个 Terminal</strong>。这次可以conda了</p><p>例如：</p><pre><code class="lang-bash">cd ~/robotics</code></pre><p>建议使用 Conda 单独建立 OpenVLA 环境：</p><pre><code class="lang-bash">conda create -n openvla python=3.10 -y
conda activate openvla</code></pre><h4 id="下载-openvla">下载 OpenVLA</h4><pre><code class="lang-bash">cd ~/robotics

git clone https://github.com/openvla/openvla.git

cd openvla</code></pre><p>OpenVLA 官方代码目前仍然以 Python 3.10 为主要环境。其经典、经过充分测试的软件组合是：</p><pre><code class="lang-text">PyTorch      2.2.x
torchvision  0.17.x
transformers 4.40.1
tokenizers   0.19.1
timm         0.9.10
flash-attn   2.5.5</code></pre><p>(<a href="https://github.com/openvla/openvla?utm_source=chatgpt.com" title="GitHub - openvla/openvla: OpenVLA: An open-source vision-language-action model for robotic manipulation. · GitHub">GitHub</a>)</p><p><strong>安装torch</strong>,老玩家直接跳过</p><p>一种稳定方案：</p><pre><code class="lang-bash">conda install \
    pytorch \
    torchvision \
    torchaudio \
    pytorch-cuda=12.4 \
    -c pytorch \
    -c nvidia \
    -y</code></pre><p>安装后：</p><pre><code class="lang-bash">python - &lt;&lt;&#x27;PY&#x27;
import torch
print(&quot;torch:&quot;, torch.__version__)
print(&quot;cuda available:&quot;, torch.cuda.is_available())
print(&quot;cuda:&quot;, torch.version.cuda)

if torch.cuda.is_available():
    print(&quot;gpu:&quot;, torch.cuda.get_device_name(0))
PY</code></pre><p>应该得到：</p><pre><code class="lang-text">cuda available: True
gpu: NVIDIA GeForce RTX 4090</code></pre><h4 id="安装-openvla">安装 OpenVLA</h4><pre><code class="lang-bash">cd ~/robotics/openvla

pip install -e .</code></pre><p>额外安装 REST Server 相关依赖：</p><pre><code class="lang-bash">pip install \
    fastapi \
    uvicorn \
    json-numpy \
    requests</code></pre><p>OpenVLA 官方自带的 <code>vla-scripts/deploy.py</code> 就是一个 FastAPI VLA Server，它暴露：</p><pre><code class="lang-text">POST /act</code></pre><p>输入：</p><pre><code class="lang-text">RGB image
language instruction
unnorm_key</code></pre><p>返回 OpenVLA action。</p><h4 id="flashattention">FlashAttention</h4><p>如果计划按照原版 OpenVLA 配置运行：</p><pre><code class="lang-bash">pip install packaging ninja</code></pre><p>确认 Ninja：</p><pre><code class="lang-bash">ninja --version
echo $?</code></pre><p>应输出：</p><pre><code class="lang-text">0</code></pre><p>然后：</p><pre><code class="lang-bash">pip install &quot;flash-attn==2.5.5&quot; --no-build-isolation</code></pre><p>如果安装 FlashAttention 出问题，注意版本问题。</p><p>OpenVLA 官方长期固定过：</p><pre><code class="lang-text">flash-attn == 2.5.5</code></pre><p>主要是因为后续 Transformers / Timm / Tokenizers 版本曾带来兼容性回归。</p><h4 id="第一次加载">第一次加载</h4><p>可以先做一个纯模型测试。</p><p>建立：</p><pre><code class="lang-bash">nano test_openvla.py</code></pre><p>写：</p><pre><code class="lang-python">from transformers import AutoModelForVision2Seq, AutoProcessor
from PIL import Image
import torch
import numpy as np


MODEL = &quot;openvla/openvla-7b&quot;

print(&quot;Loading processor...&quot;)

processor = AutoProcessor.from_pretrained(
    MODEL,
    trust_remote_code=True
)

print(&quot;Loading model...&quot;)

vla = AutoModelForVision2Seq.from_pretrained(
    MODEL,
    attn_implementation=&quot;flash_attention_2&quot;,
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=True,
    trust_remote_code=True,
).to(&quot;cuda:0&quot;)

print(&quot;Model loaded.&quot;)


# 创建一张假的 RGB 图，只用于测试 inference pipeline
image_array = np.zeros(
    (256, 256, 3),
    dtype=np.uint8
)

image = Image.fromarray(image_array)

instruction = &quot;pick up the object&quot;

prompt = (
    f&quot;In: What action should the robot take to &quot;
    f&quot;{instruction.lower()}?\nOut:&quot;
)

inputs = processor(
    prompt,
    image
).to(
    &quot;cuda:0&quot;,
    dtype=torch.bfloat16
)

action = vla.predict_action(
    **inputs,
    unnorm_key=&quot;bridge_orig&quot;,
    do_sample=False
)

print(&quot;Action:&quot;)
print(action)</code></pre><p>运行：</p><pre><code class="lang-bash">python test_openvla.py</code></pre><p>OpenVLA 的标准输出为一个 <strong>7-DoF Action</strong>。官方示例同样使用：</p><pre><code class="lang-python">predict_action(
    ...,
    unnorm_key=&quot;bridge_orig&quot;
)</code></pre><p>来获得 BridgeData 对应的动作尺度。(<a href="https://huggingface.co/openvla/openvla-7b?hardware=apple-m5-pro-48gb&amp;utm_source=chatgpt.com" title="openvla/openvla-7b · Hugging Face">Hugging Face</a>)</p><p>这里的假图没有任何机器人意义。</p><p>这一步只是检查：</p><pre><code class="lang-text">checkpoint 下载
      ↓
processor
      ↓
GPU inference
      ↓
action decoding</code></pre><p>是否正常。</p><h4 id="启动-openvla-http-server">启动 OpenVLA HTTP Server</h4><p>这是 SIMPLE 真正需要连接的服务。</p><p>Terminal A：</p><pre><code class="lang-bash">conda activate openvla

cd ~/robotics/openvla</code></pre><p>如果有两张 GPU，希望 OpenVLA 使用 GPU 1：</p><pre><code class="lang-bash">export CUDA_VISIBLE_DEVICES=1</code></pre><p>然后：</p><pre><code class="lang-bash">python vla-scripts/deploy.py \
    --openvla_path openvla/openvla-7b \
    --host 0.0.0.0 \
    --port 21075</code></pre><p>OpenVLA 官方 <code>deploy.py</code> 内部就是：</p><pre><code class="lang-text">POST /act

{
    &quot;image&quot;: ...,
    &quot;instruction&quot;: ...,
    &quot;unnorm_key&quot;: ...
}</code></pre><p>然后：</p><pre><code class="lang-python">action = vla.predict_action(...)</code></pre><p>最后将 action 返回给 Client。(<a href="https://github.com/openvla/openvla/blob/main/vla-scripts/deploy.py?utm_source=chatgpt.com" title="openvla/vla-scripts/deploy.py at main · openvla/openvla · GitHub">GitHub</a>)</p><h3 id="测试-server">测试 Server</h3><p>可以建立一个简单 Python Client：</p><pre><code class="lang-bash">nano test_server.py</code></pre><p>内容：</p><pre><code class="lang-python">import requests
import json_numpy
import numpy as np

json_numpy.patch()

image = np.zeros(
    (256, 256, 3),
    dtype=np.uint8
)

payload = {
    &quot;image&quot;: image,
    &quot;instruction&quot;: &quot;pick up the object&quot;,
    &quot;unnorm_key&quot;: &quot;bridge_orig&quot;,
}

response = requests.post(
    &quot;http://127.0.0.1:21075/act&quot;,
    json=payload,
    timeout=120,
)

print(response.status_code)
print(response.json())</code></pre><p>安装：</p><pre><code class="lang-bash">pip install requests json-numpy</code></pre><p>运行：</p><pre><code class="lang-bash">python test_server.py</code></pre><p>预期：</p><pre><code class="lang-text">200
[ ... seven action values ... ]</code></pre><p>至此，OpenVLA Server 已经正常。</p><h4 id="simple-+-openvla-最小闭环-demo">SIMPLE + OpenVLA 最小闭环 Demo</h4><p>现在打开 Terminal B。</p><p>进入 SIMPLE：</p><pre><code class="lang-bash">cd ~/robotics/SIMPLE

source .venv/bin/activate</code></pre><p>如果有两张 GPU，希望仿真使用 GPU 0：</p><pre><code class="lang-bash">export CUDA_VISIBLE_DEVICES=0</code></pre><p>Isaac Sim：</p><pre><code class="lang-bash">export ACCEPT_EULA=Y
export OMNI_KIT_ACCEPT_EULA=YES</code></pre><p>headless：</p><pre><code class="lang-bash">export MUJOCO_GL=egl</code></pre><p>然后执行 SIMPLE 官方 OpenVLA Demo：</p><pre><code class="lang-bash">MUJOCO_GL=egl uv run eval \
    simple/FrankaTabletopGrasp-v0 \
    openvla \
    --host=127.0.0.1 \
    --port=21075 \
    --sim-mode=mujoco_isaac \
    --headless \
    --max-episode-steps=50</code></pre><p>这正是 SIMPLE 当前官方文档给出的 OpenVLA 示例。</p><p>其结果默认可以在：</p><pre><code class="lang-text">./data/evals/openvla</code></pre><p>中查看。</p><h3 id="启动架构">启动架构</h3><p>执行：</p><pre><code class="lang-bash">uv run eval \
    simple/FrankaTabletopGrasp-v0 \
    openvla \
    ...</code></pre><p>其流程——</p><pre><code class="lang-text">SIMPLE
  │
  ├─ reset Franka environment
  │
  ├─ render camera RGB
  │
  ├─ obtain language instruction
  │
  └─ OpenVLA Agent Adapter
          │
          │ HTTP
          ▼
      OpenVLA Server
          │
          ├─ processor(image, instruction)
          │
          ├─ OpenVLA inference
          │
          └─ predict_action()
          │
          ▼
       7-D action
          │
          ▼
      SIMPLE Adapter
          │
          ▼
       Franka</code></pre><p>正是后续实验非常好扩展的地方。</p><p>可以把OpenVLA换成：</p><pre><code class="lang-text">OpenVLA + Noise
OpenVLA + Tracker
OpenVLA + Action Filter
OpenVLA + Replanning
OpenVLA + RTC
OpenVLA + Dynamic Target Tracking</code></pre><p>而不修改 SIMPLE 的核心仿真逻辑。</p><hr/><h3 id="qa">QA</h3><ol start="1"><li>为什么第一步应该用 Franka，而不是直接上 G1？</li></ol><p>原始 OpenVLA 的基础输出是：</p><pre><code class="lang-text">7-DoF manipulator action</code></pre><p>大体可以理解成：</p><pre><code class="lang-text">Δx
Δy
Δz
ΔRx
ΔRy
ΔRz
gripper</code></pre><p>它原本就是针对 Open-X Embodiment 中大量机械臂操作数据训练的。</p><p>而 SIMPLE 的 G1 Whole-body Task 动作空间完全不同。</p><p>例如 humanoid whole-body 任务可能涉及：</p><pre><code class="lang-text">base locomotion
torso
left arm
right arm
hand
whole-body controller</code></pre><p>因此：</p><pre><code class="lang-text">OpenVLA-7B
       ↓
原始 7-D Action</code></pre><p>不能直接等价为：
G1 Whole-Body Action</p><p>所以环境验证阶段非常适合先跑：
FrankaTabletopGrasp-v0</p><p>确认：</p><pre><code class="lang-text">视觉
→ VLA
→ 动作
→ 仿真执行</code></pre><p>这一闭环完全正确。</p><p>之后如果研究目标确实是 Humanoid VLA，再单独设计：</p><pre><code class="lang-text">VLA action representation
         ↓
whole-body action adapter
         ↓
WBC
         ↓
G1</code></pre><ol start="2"><li>OpenVLA 的 Zero-shot 限制？</li></ol><p>这一点实验设计里必须明确。</p><p>OpenVLA 官方明确说明：</p><blockquote><p>模型不能假设可以 zero-shot 泛化到训练数据完全没见过的机器人 embodiment。</p></blockquote><p>也就是说：</p><pre><code class="lang-text">OpenVLA pretrained
        ↓
陌生机器人 + 陌生动作空间</code></pre><p>失败不能直接得出：
OpenVLA 的视觉理解能力差</p><p>因为失败可能来自：</p><pre><code class="lang-text">视觉 domain mismatch
action normalization mismatch
robot embodiment mismatch
camera mismatch
control frequency mismatch
gripper semantic mismatch</code></pre><p>OpenVLA 官方同样建议，对新的 robot setup 收集 demonstration 后再进行 fine-tuning。(<a href="https://huggingface.co/openvla/openvla-v01-7b?utm_source=chatgpt.com" title="openvla/openvla-v01-7b · Hugging Face">Hugging Face</a>)</p><p>因此第一阶段实验应该被称为：</p><pre><code class="lang-text">pipeline validation / policy integration validation</code></pre><p>而不是严谨的：</p><pre><code class="lang-text">OpenVLA generalization benchmark</code></pre><p>
<!-- -->
<!-- -->
<!-- -->
<!-- -->
<!-- -->
<!-- -->
</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/embody-ai/openvla-simple#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>具身学习002：pi R2与WAM的信息门控</title>
            <link href='https://www.sorodo.xyz/posts/embody-ai/piR2-WAMgateNoise'/>
            <id>https://www.sorodo.xyz/posts/embody-ai/piR2-WAMgateNoise</id>
            <published>2026-09-01T03:38:49.807Z</published>
            <updated>2026-09-04T16:51:58.654Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/embody-ai/piR2-WAMgateNoise'>https://www.sorodo.xyz/posts/embody-ai/piR2-WAMgateNoise</a></blockquote>
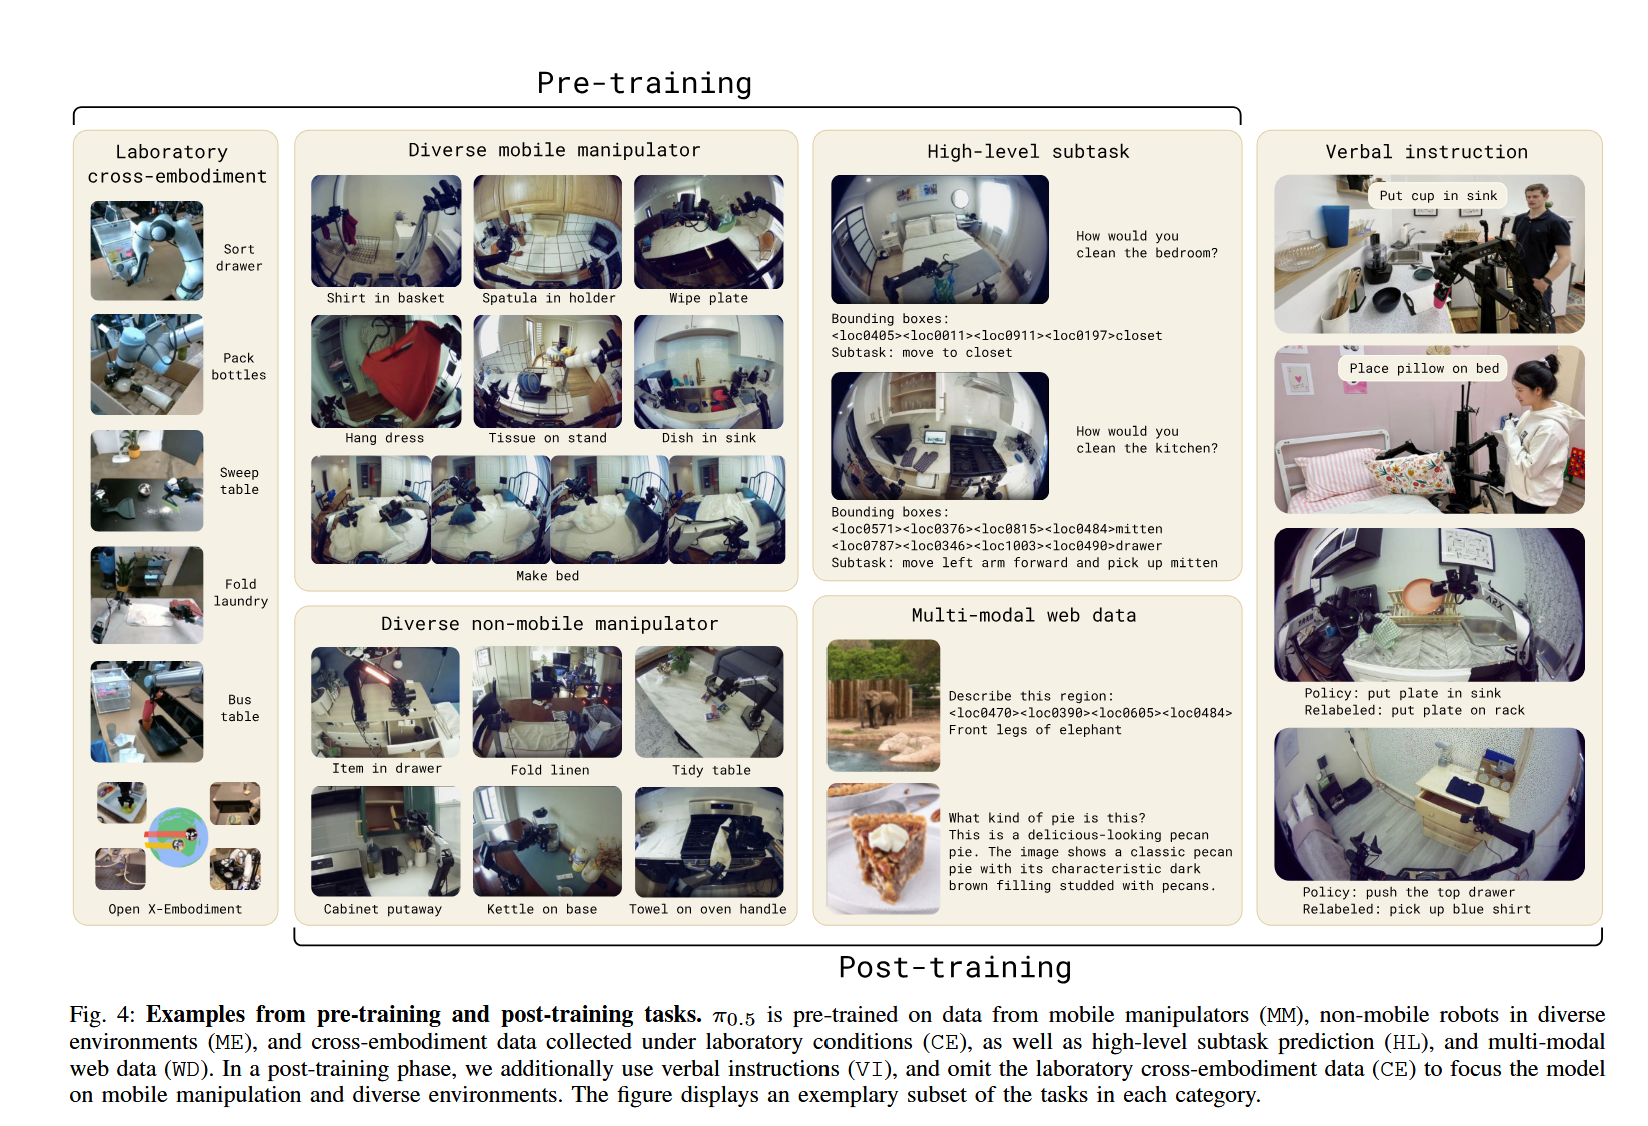
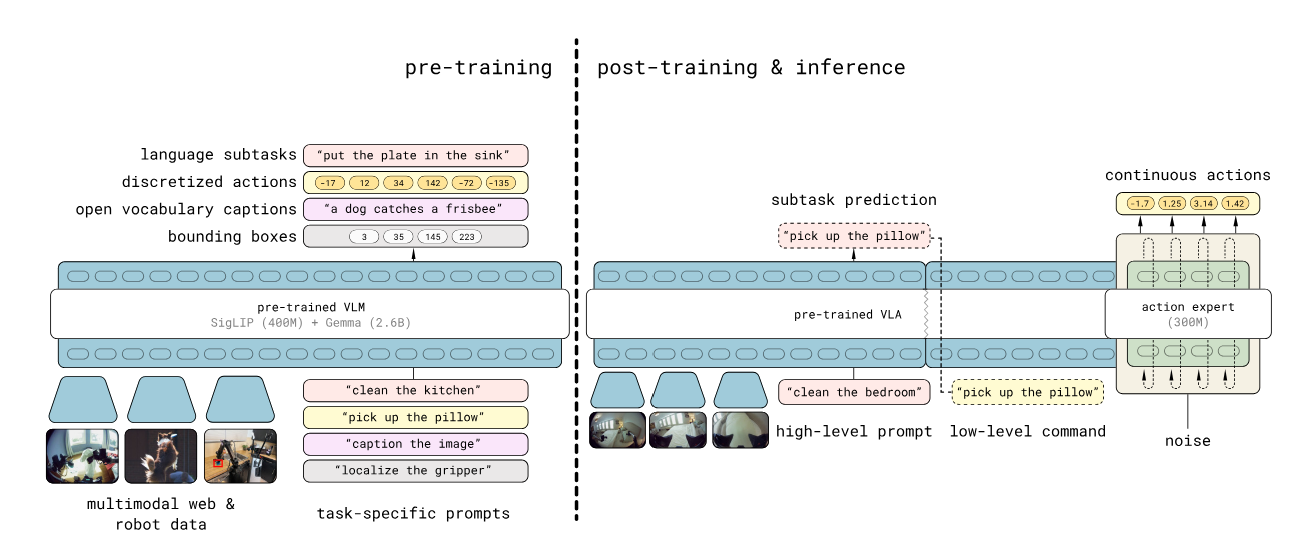
<div><div><h3 id="前言">前言</h3><p>传送门：</p><p><a href="https://github.com/pi-r2-flow/pi-r2-flow">pi R^2</a></p><p><a href="https://arxiv.org/abs/2605.07794">NoiseGate: Learning Per-Latent Timestep Schedules as Information Gating in World Action Models</a></p><h3 id="pi-r2">pi-R2</h3><p>虽然写的是比较新的算法，粗读概括来说是pi系列融合了SLAM的思想，快慢刀处理信息流。但是也要顺路读一下 pi 系列的算法（特别是π0.5）。</p><h4 id="pi-0.5">pi-0.5</h4><p>VLA的经典了。<a href="https://github.com/Physical-Intelligence/openpi">https://github.com/Physical-Intelligence/openpi</a></p><h5 id="训练">训练</h5><p>训练分为两个阶段，预训练和后训练</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/02/P3fmbbTc.png"/></p><p><strong>预训练</strong>：用海量混合数据训练出第一个版本的VLA模型，这个版本的动作输出是离散的“动作令牌”（discrete tokens）。也是标准的VLA模型，以及经典的Transfomer</p><p>这里用的数据相当多——</p><ul><li><p>多种机器人平台的数据：不同的机器人（机械臂、轮式机器人等）做各种任务的数据。</p></li><li><p>高层语义动作预测：比如“去厨房”“打开抽屉”这类抽象层次的动作标签，帮助模型理解“任务意图”。</p></li><li><p>网络数据：网页上的图像、视频、文本，帮助模型建立视觉和语言的常识。</p></li></ul><p>动作表示——FAST动作分词器</p><p>机器人动作本来是连续数值（比如关节角度、移动速度、关节坐标）。
预训练阶段用了一个叫 FAST 的分词器，把连续动作切成一串离散的“动作单词”，就像把一句话拆成一个个中文汉字。
因为离散token可以像处理文本一样处理动作，能更稳定地利用大规模异构数据，让模型在预训练阶段“见多识广”。</p><p><strong>后训练</strong>：在预训练的基础上，专门针对移动操作（比如机器人自己在房间里走动、拿东西、放东西）进行微调，让模型擅长输出细粒度连续动作。</p><p>挑选了最任务相关的数据，特别是人类监督者的口头指令。比如人在旁边说：“把红色杯子放到桌上”“先走到冰箱前”……这些语言信息能教会模型理解真实场景中人类如何下达指令。</p><p>预训练用的是“离散token”，后训练改用 Flow Matching 来直接学习连续动作分布。
可以把Flow Matching理解成一个“动作生成器”：
从单词变成直接推断出一个流畅的、连续的动作轨迹。优点是实时性高：计算效率高，能支持机器人实时响应。
还有精度高：能表达非常精细的动作，比如轻轻拿起鸡蛋、精确放到某一点。</p><p>当然，最后实际规划的时候还是有：</p><p>推理——先规划高层子任务，再生成连续动作</p><p><strong>模型</strong></p><pre><code>                      ┌─────────────────────────────┐
图像 ──&gt; SigLIP ─────&gt;│                             │
语言 token ──────────&gt;│   大型 PaliGemma / VLM expert│
                      │                             │
                      └──────────────┬──────────────┘
                                     │ 每一层通过注意力提供 K/V
                                     ▼
状态/带噪动作 ──&gt; 投影 ──&gt; 小型 action expert ──&gt; 连续动作向量场</code></pre><p>相当于两个transformer。一路是VLM，一路是动作生成专家</p><ol start="1"><li><p>图像编码器：SigLIP
把多路相机图像变成 image tokens。其实就是PaliGemma使用的视觉编码器。(笔注，对比CLIP的softmax对比学习——把每个“图像-文本”对都当作一个独立的二分类问题： 正样本对 (i, i)：标签为 1，希望模型输出接近 1；负样本对 (i, j), i ≠ j：标签为 0，希望模型输出接近 0。)</p></li><li><p>主干 Transformer ：PaliGemma / Gemma
负责融合图像、语言和动作上下文。（PaliGemma 是一个基于 SigLIP-So400m 视觉编码器和 Gemma-2B 语言模型的开放视觉语言模型（VLM）。它被训练为一个多功能且知识广泛的基础模型，能够有效迁移。）</p></li><li><p>Action expert
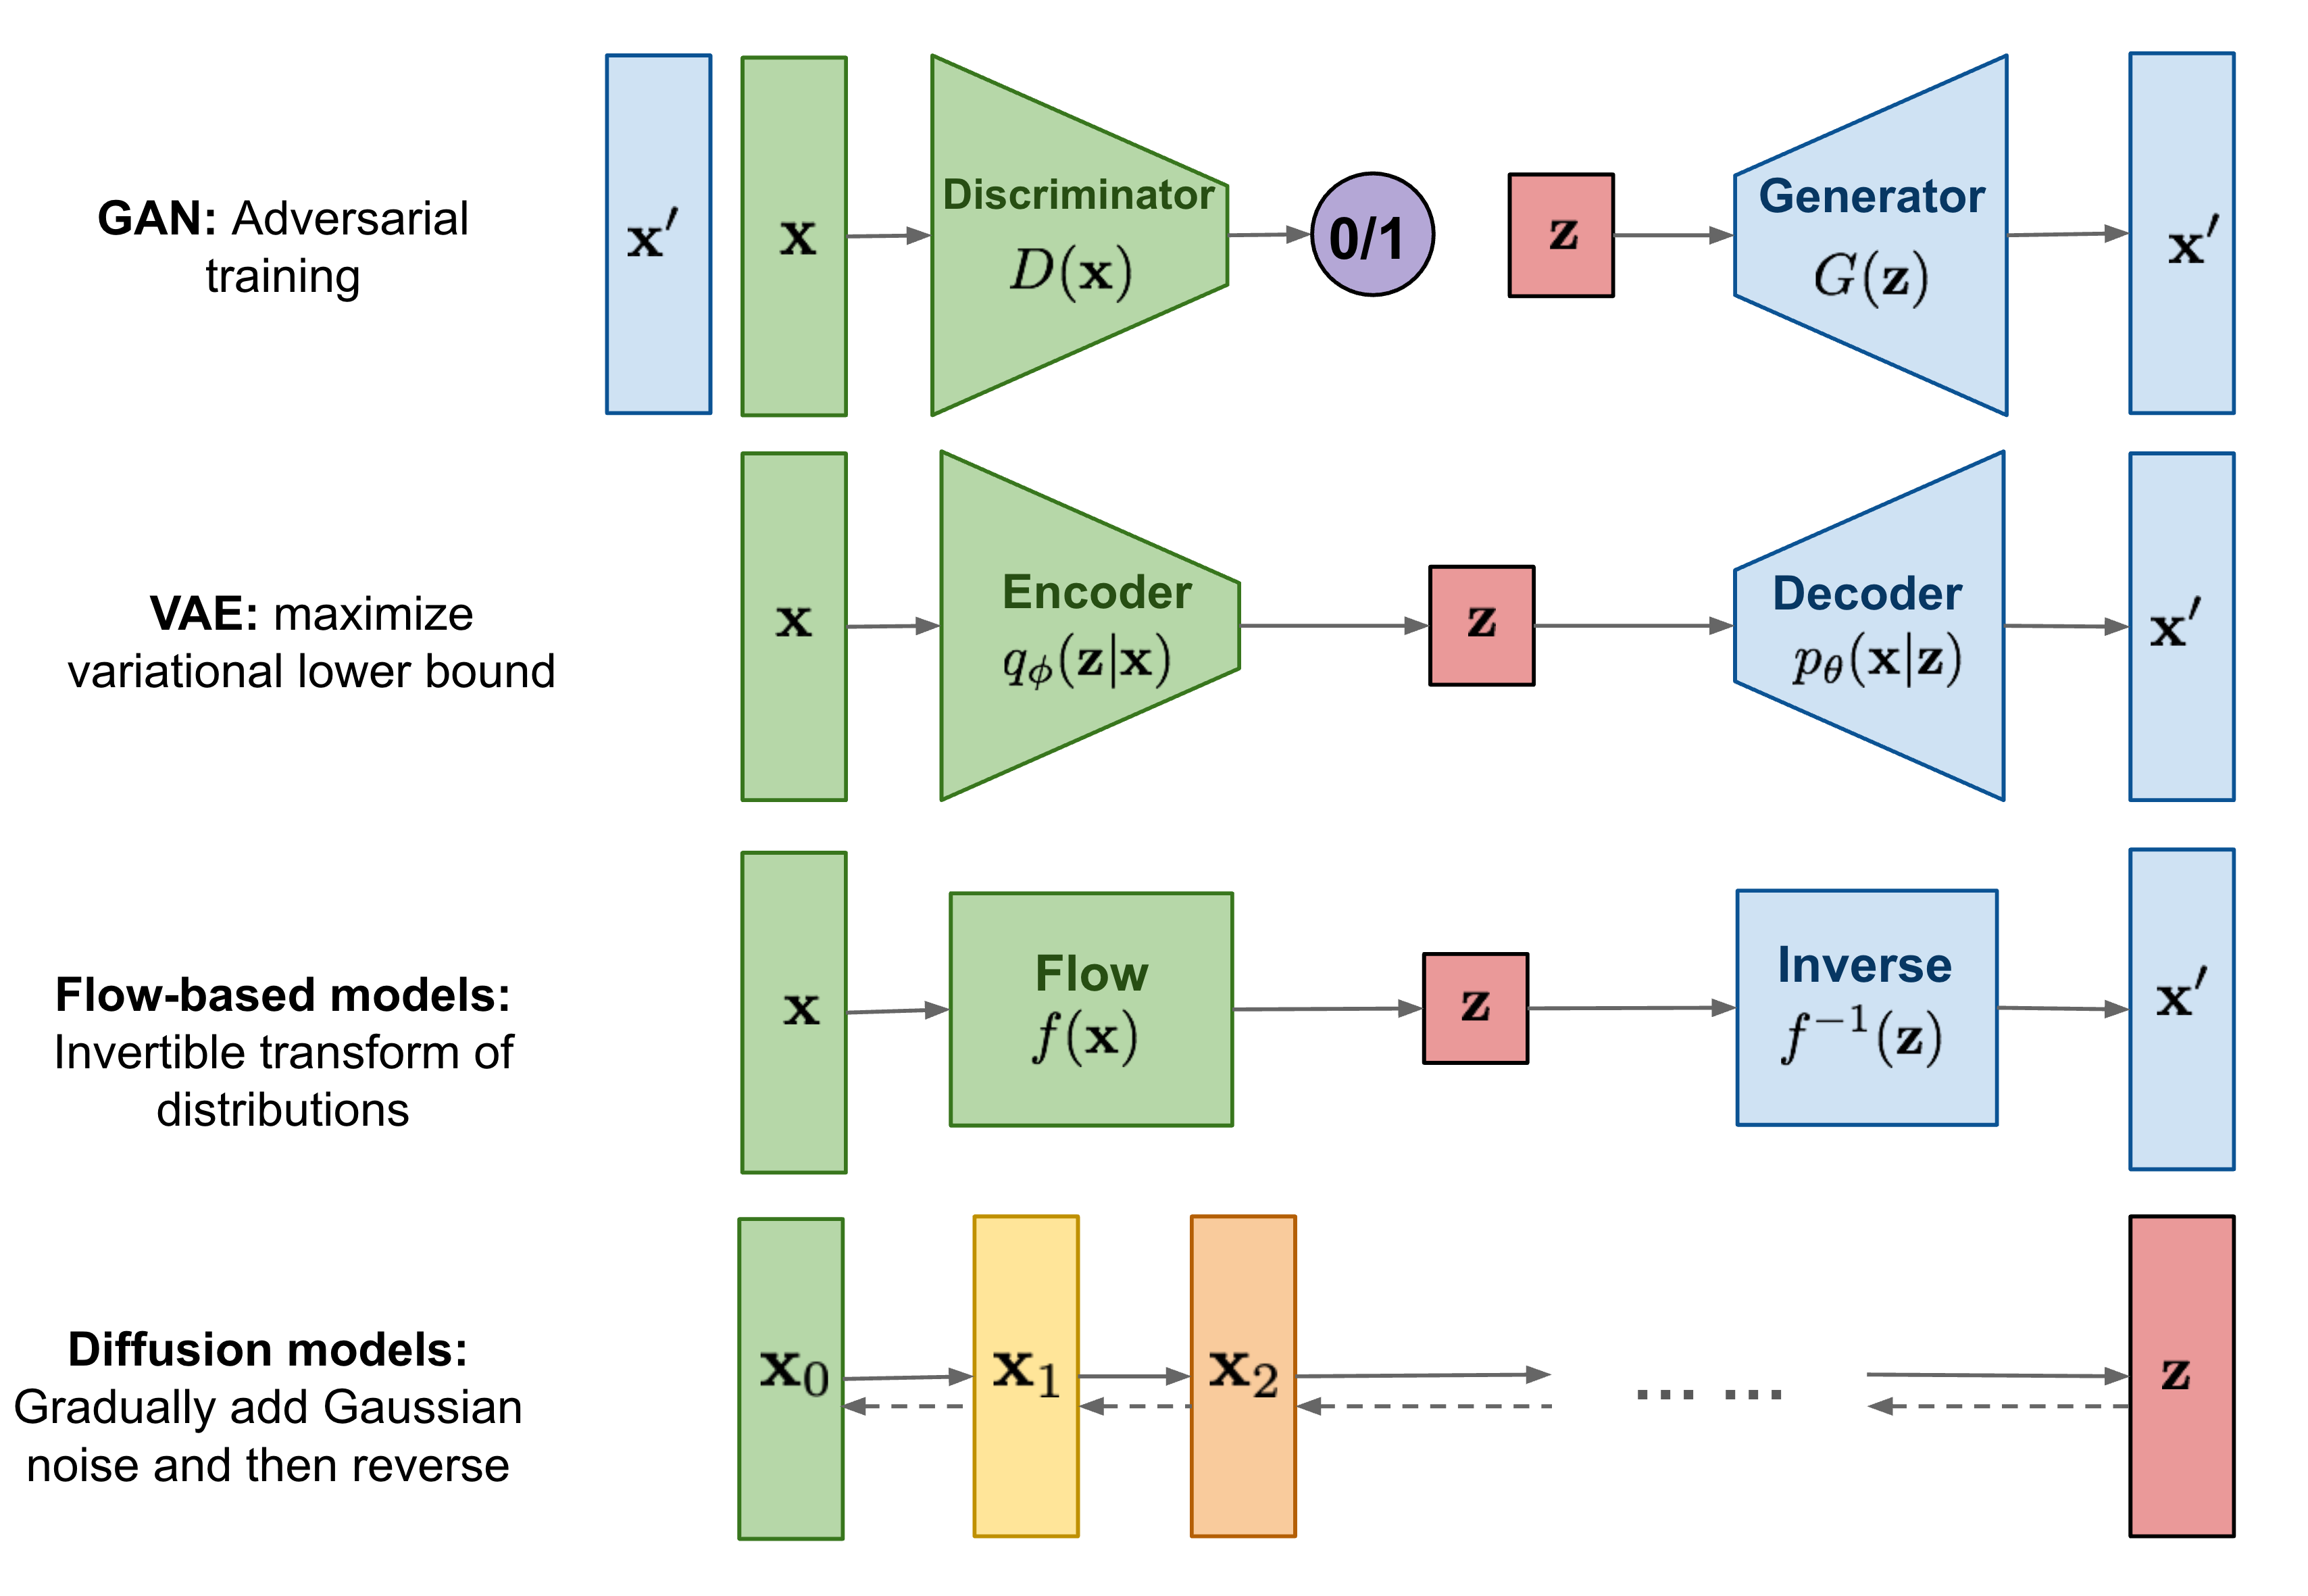
动作侧的专门分支：输入 noisy action tokens 输出 flow matching 得到的速度场</p></li></ol><p>顺便复习一下经典的4大生成模型：</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/02/sMn5T5gQ.png"/></p><p>拆解一下这个backbone，就是图像编码器加一个大模型transfomer和一个流匹配的动作专家模型。</p><p>不过单纯讲解还是很模糊，拿数据箱子举例：</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/02/PoI9lMoW.png"/></p><p><strong>输入</strong></p><pre><code>episode:
    task_instruction: str

    timestep 0:
        camera_0: uint8[H_img, W_img, 3]
        camera_1: uint8[H_img, W_img, 3]
        ...
        robot_state: float[d_state]
        action: float[d_action]

    timestep 1:
        ...</code></pre><p>比如取样时间t，这个时间下采样多个相机的图像I；当前关节位置、夹爪状态、底盘速度等本体状态q；任务语言L；从当前开始的未来 50 步动作块A。</p><pre><code>单步动作 a_t:       float[32]
50 步动作块 A_t:    float[50, 32]</code></pre><p>虽然原版的机器人是18维度的动作，不过pi0.5为了兼容更多的机器人，动作设置为32维，空缺的地方进行0填充</p><p>其他格式如：原始 uint8 图像会转换到 ([-1,1])，缩放到 (224\times224)。训练时还会做裁剪、旋转和颜色扰动；缺失的相机通过 image_mask 屏蔽</p><pre><code class="lang-python">{
    &quot;image&quot;: {
        &quot;base_0_rgb&quot;:        float32[B, 224, 224, 3],
        &quot;left_wrist_0_rgb&quot;:  float32[B, 224, 224, 3],
        &quot;right_wrist_0_rgb&quot;: float32[B, 224, 224, 3],
    },

    &quot;image_mask&quot;: {
        &quot;base_0_rgb&quot;:        bool[B],
        &quot;left_wrist_0_rgb&quot;:  bool[B],
        &quot;right_wrist_0_rgb&quot;: bool[B],
    },

    &quot;state&quot;:                 float32[B, d],  # pi0.5这里state会缩放到0-255并处理为文本,如&quot;23 7 254 ...&quot;
    &quot;tokenized_prompt&quot;:      int32[B, L], 
    &quot;tokenized_prompt_mask&quot;: bool[B, L],

    &quot;actions&quot;:               float32[B, 50, d],
}</code></pre><p>对比一下老大哥pi0的数据流也：</p><table><thead><tr><th>数据</th><th>π0 中走哪条路</th><th>π0.5 中走哪条路</th></tr></thead><tbody><tr><td>RGB 图像</td><td>SigLIP → VLM expert</td><td>SigLIP → VLM expert</td></tr><tr><td>语言指令</td><td>词嵌入 → VLM expert</td><td>词嵌入 → VLM expert</td></tr><tr><td>当前 robot state</td><td>线性投影 → action expert</td><td><strong>离散化为文本 token → VLM expert</strong></td></tr><tr><td>FAST 动作 token</td><td>不使用</td><td><strong>VLM expert → vocabulary head</strong></td></tr><tr><td>连续带噪动作</td><td>action expert</td><td>action expert</td></tr><tr><td>文本、框、子任务输出</td><td>不监督</td><td><strong>vocabulary head</strong></td></tr><tr><td>连续动作向量场</td><td>flow output projection</td><td>flow output projection</td></tr></tbody></table><h5 id="输出">输出</h5><p>pi0.5的输出也分为两类：</p><pre><code>VLM vocabulary head:
    text logits
    bbox/location token logits
    FAST action token logits

action expert:
    continuous flow vector [B,50,d]</code></pre><p>关于FAST。一开始疑惑了一下，仔细读原文才知道这个主要用于扩展训练。</p><p>无论是监督用的action还是输出都要化为VLM原生支持的文字tokens。这样相比原先连续动作的监督，可以用于训练的数据也大大增加了。也是在此基础上，预训练VLM（预训练阶段flow不激活）就可以用互联网的各种文字和视觉信息训练（这个阶段的动作都只是tokens）。后训练阶段再激活flow matching部分的训练，学习后半段的连续动作的输出。</p><p>关于论文提到的各种不同的数据怎么用于训练的，也是很值得称道的数据工程。。以后有机会单开一页学习一下。而且不同样本使用的激活和输入输出都不太一样。</p><h5 id="前向传播过程">前向传播过程</h5><p>高层推理，仅仅VLM，action expert不运行。</p><pre><code>输入：
    四个相机图像
    当前 state token
    整体任务 &quot;clean the bedroom&quot;

激活：
    SigLIP
    VLM expert
    vocabulary head

输出：
    bbox/location tokens
    子任务 &quot;pick up the pillow&quot;</code></pre><p>低层推理，同样的模型，但是动作专家激活，输出连续高频的动作控制。</p><pre><code>输入：
    前向相机和腕部相机
    当前 state token
    低层命令 &quot;pick up the pillow&quot;
    初始随机动作噪声 [50,d]

激活：
    SigLIP
    VLM expert，产生 prefix context
    action expert
    flow head

输出：
    continuous actions [50,d]</code></pre><h4 id="回到pi-r2">回到pi-R2</h4><p>关于最新的R2，解决的问题稍微不太一样。首先看看名字：Reactive Real-time。这就是R2由来。很明显，这次奔着实时性走的。</p><p>面向所有“重型视觉语言骨干 + flow action head + action chunking”类型的机器人策略，论文实际把它加在 NVIDIA GR00T-N1.7 上验证。</p><p>过去的算法复杂度和智能度增加(大型预训练backbone，压缩性策略架构如diffusion和流式匹配，动作分块)导致反应性有限且延迟增加，使这些基础模型不适合需要快速、平滑和反应式控制的动态操作任务。具体来说，预测动作的 <strong>“块”执行是开环的</strong> ，无法对传入的感官输入做出反应。理论上，通过只执行一个小的“子块”（极限仅一次动作）并用更新的感官输入重新预测来提升反应性，但由于需要大量计算，天真地这样做是不可行的。</p><p>顺便这边关注的是当前具身算法的三大改良点：</p><ol start="1"><li><p>大型预训练backbone：这个不用说，算力为王</p></li><li><p>压缩性策略架构如diffusion和流式匹配：两个都是生成模型的典范，扩散模型通过逐步去噪来生成数据；流匹配则通过学习一个连续变换来拟合数据分布。</p></li><li><p>动作分块：传统的行为克隆（或强化学习策略）通常是自回归式的，即每次观测当前状态，只预测一个动作（a<em>t）。而动作分块（如ACT、RT-2等）的核心方法是一次性预测未来一段时间（H步）内的连续动作序列（即一个“块”或“chunk”，如 [a_t, a</em>{t+1}, ..., a_{t+H-1}]）。</p></li></ol><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/01/4HVvpQV2.png"/></p><p>详细展开这个<strong>动作块开环执行</strong>问题：</p><h5 id="动作开环的多步flow">动作开环的多步flow</h5><p>对于其生成动作：从随机噪声开始，经过多次 flow matching 更新，生成一整个动作块：</p><pre><code>A_t = [a_t, a_{t+1}, ..., a_{t+49}]</code></pre><p>接下来机器人执行这个动作块中的若干个动作，再重新调用模型。中间的这个过程是不会有新的感知输入再进入模型调用的。中间任何其他的环境变化或者摩擦都是空白，执行完了再输出下一个动作。如果是水杯掉落这种情况，机械缓慢的更新肯定不可取。</p><p>π0.5 原始系统为了避免异步切换动作块产生跳变，采用同步执行：执行完一块后等待模型生成下一块，因此动作块之间可能出现停顿。Physical Intelligence 后续的 RTC 工作也明确指出，π0、π0-FAST 和 π0.5 最初并没有使用实时异步执行策略。</p><p>所以最直接的方法就是如上每一个动作块生成后立即调用新的。不要执行 50 步，每次只执行 1 步，然后立刻重新看图、重新规划。</p><p>不过实际上VLA推理很昂贵。以论文的GR00T-N1.7 为例子，图像预处理 + VLM：约 60 ms，4 次 flow denoising：约 80 ms，总计：约 140 ms。</p><p>RTC 的解决思路是：告诉新模型“在你计算期间，这几个动作已经确定会执行”，让新动作块以它们作为前缀。但 RTC 主要解决的是动作块接缝连续性，仍然没有让流策略在动作块内部持续读取最新的传感器反馈数据。而且我们要注意到，延迟也并非固定，所以计算期间的这个期间——也很难计算。</p><p><strong>来到pi-R2的思路：</strong></p><p>和丢弃旧的，增加新的未来动作tokens不同，其直接维护一个持续存在、不断向前滚动的动作缓冲区：</p><pre><code>已经确定的近期动作
        ↓
正在逐渐精修的中期动作
        ↓
还很模糊的远期动作
        ↓
刚加入的纯噪声</code></pre><p>每次控制调用只做一次网络前向，但一个动作在抵达缓冲区前端之前，已经跨越多个控制周期、经历了多次逐步去噪。</p><p>相当于滑窗式扩散，类似以前是一次生成50步x50次去噪，现在是对未来最新的50步进行一次去噪，最近的一个动作到了要执行的时候已经去噪过50次了就可以直接输出了。相当于n方到n的优化。</p><h5 id="观察者快慢通道">观察者快慢通道</h5><p>第二个重要设计。初看名词很容易联系到SLAM里面的快慢线程（里程计和后端全局优化）</p><p>慢通道：</p><pre><code>RGB 图像
语言任务
VLM 视觉语言特征</code></pre><p>回顾之前的结构，这里要通过图像编码器和语言一起送入VLM最后得到输出的tokens。这一步比较耗时。不过语言任务通常不会每 20～40 ms 改变一次，而视觉信息对一些精细接触修正也不一定需要每个控制周期重新完整理解。</p><p>快通道：</p><pre><code>关节角
关节速度
关节力矩
末端执行器姿态
手指接触力
触觉信号
当前控制误差</code></pre><p>执行结构：</p><pre><code>                    慢线程
新图像 + 语言 ──&gt; Vision Encoder ──&gt; VLM
                                      │
                                      ▼
                              cached slow feature
                                      │
                                      │ 异步更新
                                      ▼
最新 proprioception ──&gt; state projector ──┐
                                          │
滚动动作缓冲区 ──&gt; action projector ───────┼─&gt; DiT action head
                                          │
每位置 τ_p + 延迟信息 ────────────────────┘
                                          │
                                          ▼
                                  action velocity</code></pre><p>对于action head——Action head：高频运行，每次都读取最新 proprioception，使用最近一次完成的 VLM 特征。</p><p>快慢刀思想，也是程序里面常用的设计了。确实可以尝试多多迁移SLAM里面的各种设计思路。</p><p>当然，对于动作头，除了使用VLM给出的视觉语言感知，还有一个很重要的点在于给视觉加权：</p><pre><code>d_vis = 0：
    图像很新，可以更加信任精确位置

d_vis = 4：
    图像已经旧了，不应过分依赖其中的精细几何位置
    应更多参考最新的 proprioception</code></pre><p>这一点根据图像时间进行退化。</p><h5 id="动作阶梯">动作阶梯</h5><p>当然，考虑这两个R，我们的实时性还是差一步——最后的动作头计算依旧有延迟。</p><p>虽然算出了最新的动作，但是输出到连续量还有80ms的计算时间。这里可能已经过了两步动作了。所以实际情况是最近的几步动作噪声都是干净的，阶梯规划动作。大致如下：</p><pre><code>位置 p：
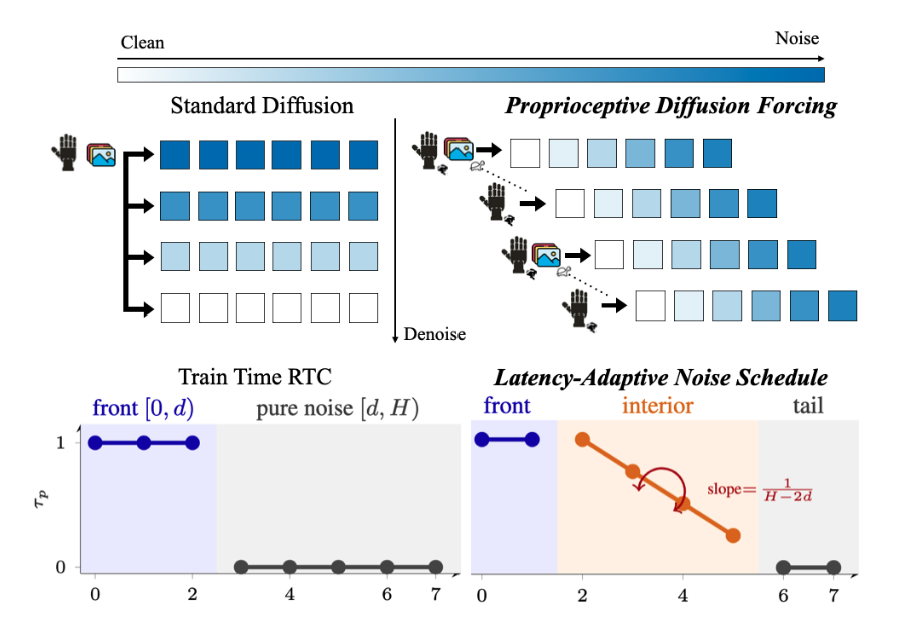
      0    1    2    3    4    5    6    7

τ_p：
     1.0  1.0  1.0  .75  .50  .25  0.0  0.0</code></pre><p>其中0-1都是推理过程必然执行的工作，2-3是未来要执行的动作。4-5，6-7则是比较靠后等待去噪，新输入的动作。</p><p>π0.5 的 action expert 使用 flow 时间调制 adaptive RMSNorm。但是R2自身是按位置进行时序变化的，所以论文也强调了按位置调制的思想。不过这一点就是控制这个τ数据，没什么特别值得扩展的。</p><p>顺便对比之前的算法，其输入输出维度增加了不少：</p><p>45 维 proprioception 包括：</p><pre><code>6 个机械臂关节角
12 个灵巧手关节角
12 个关节力矩
15 个指尖三轴接触力</code></pre><p>18 维动作则是：</p><pre><code>6 个机械臂关节目标
12 个手指关节目标</code></pre><p>顺便论文在真实机器人上使用的是 GR00T-N1.7，而不是 π0.5。</p><h3 id="wam的信息门控">WAM的信息门控</h3><p>世界模型蹭上VLA就像VLM蹭上action一样。现在来了个WAM。</p><p>世界动作模型（WAM）通过在给定当前观察潜在 v0 和语言指令 l 的情况下，对 F 个未来潜在帧 v = (v1, . . , vF ) 和一个动作块 a 的联合分布 p(v, a | v0, l) 进行建模，概括了经典的视频语言动作策略。当前的 WAM 通常使用扩散或流匹配 Mixture-of-Transformers 来联合对未来潜伏和动作令牌进行去噪。</p><p>输入和VLA一样，输出类似一个建模。或者说给VLA的输出结果加了一个视频帧，同步扩散得到的除了a还有个v。</p><p>先看看这一篇NoiseGate解决的是什么问题：</p><ul><li>当前的WAM对未来的latent帧共享同一个噪声时间步t。这个强先验不合理。</li></ul><p>比如在抓取之前的那一帧很关键且最不确定，就保持模糊更久一点（高t），这样动作的生成不会过度信赖一个不可靠的想象v。同样一些确定好的背景帧可以早一点清晰化。</p><p>与前面的Pi-R2类似的是都对当前生成模型的t相同产生了质疑和打破。</p><p>NoiseGate解决的就是如何让每一帧都有自己的t_f（一个向量而不是标量，同时监督a的生成），这个每一帧的清晰度按哦由一个小的网络GPN单独进行+强化学习学出来，而非手工定。（ps，论文这里也指出一些强化学习的方法对VLA的改善）</p><h4 id="方法论">方法论</h4><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/03/t4JTer0N.png"/></p><p>统一框架图总结了联合序列 MoT 主干和门控策略网络（GPN）。在每个去噪步骤中，GPN 都会读取当前预测的块潜伏和每个潜伏时间，并发出 v 的增量 Δtf。观察 v0 固定在 t0 = 0，并且操作遵循其自己的全局时间表。</p><p><strong>训练流程</strong></p><pre><code>────────────────────────────────────────────
Stage 1：训练异构 timestep WAM
────────────────────────────────────────────

机器人示范：
当前画面 + 未来画面 + 动作块 + 语言
                    │
                    ▼
未来画面编码为 v1...vF
                    │
每个 vf 独立采样 tf，动作单独采样 ta
                    │
                    ▼
[v0 clean | v1^t1 | ... | vF^tF | a^ta]
                    │
                    ▼
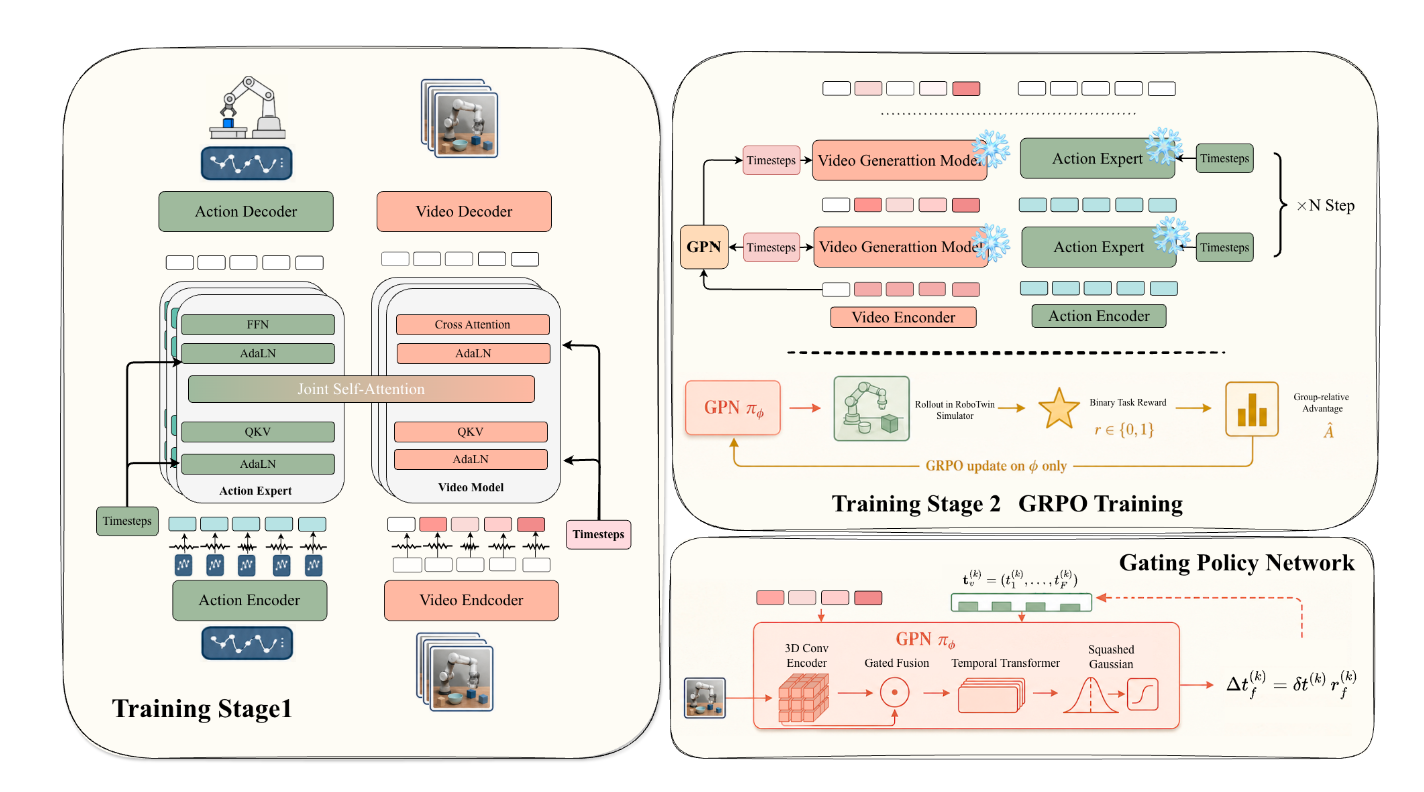
joint video–action MoT
                    │
                    ▼
视频去噪 loss + 动作去噪 loss
                    │
                    ▼
更新 WAM


────────────────────────────────────────────
Stage 2：学习 timestep gating policy
────────────────────────────────────────────

冻结 WAM
                    │
模拟器当前观察 → clean v0
                    │
未来 latent、action 从噪声开始
                    │
                    ▼
第 k 次去噪：
GPN 读取当前 future latents + t1...tF
                    │
                    ▼
输出每个 latent 的倍率 m1...mF
                    │
                    ▼
Δtf = nominal_delta × mf
                    │
                    ▼
WAM 按新的 t vector 联合更新视频和动作
                    │
重复 10 次
                    ▼
执行生成动作
                    │
                    ▼
任务成功/失败 reward
                    │
                    ▼
GRPO：
成功 schedule 提高概率
失败 schedule 降低概率
                    │
                    ▼
只更新 GPN</code></pre></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/embody-ai/piR2-WAMgateNoise#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>具身学习ing-01：机器人的感知与具身当前的评测标准</title>
            <link href='https://www.sorodo.xyz/posts/embody-ai/dyana-esi'/>
            <id>https://www.sorodo.xyz/posts/embody-ai/dyana-esi</id>
            <published>2026-08-31T15:45:40.794Z</published>
            <updated>2026-09-01T14:46:37.064Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/embody-ai/dyana-esi'>https://www.sorodo.xyz/posts/embody-ai/dyana-esi</a></blockquote>
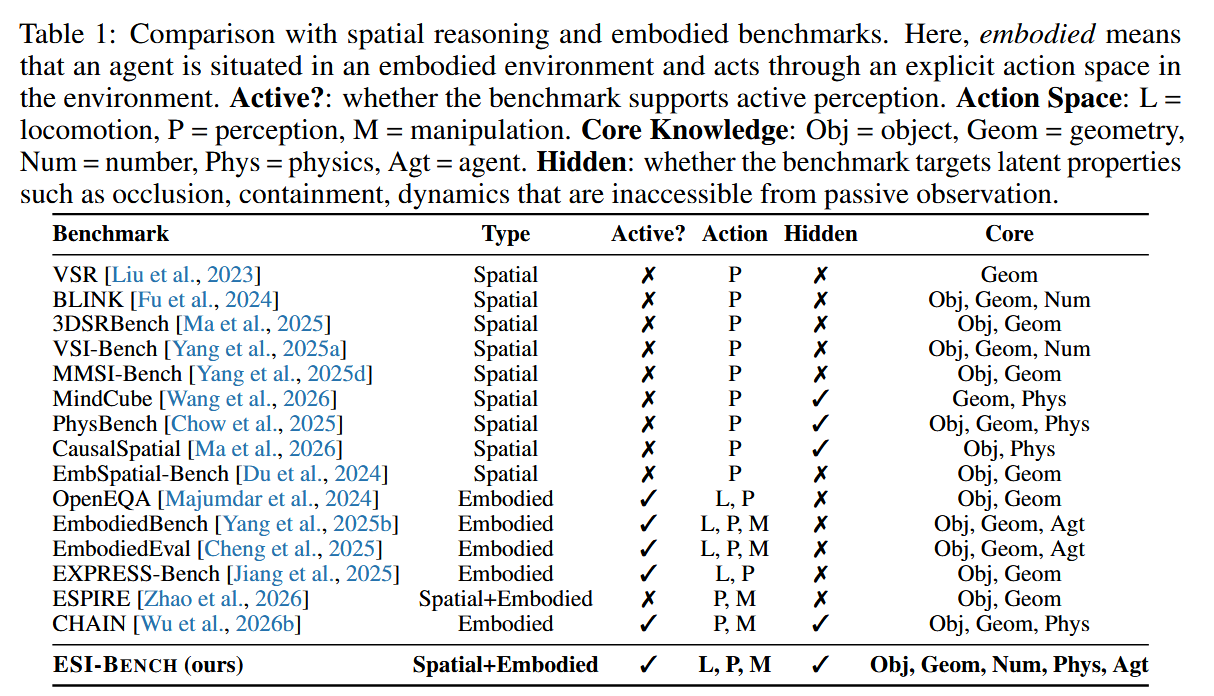
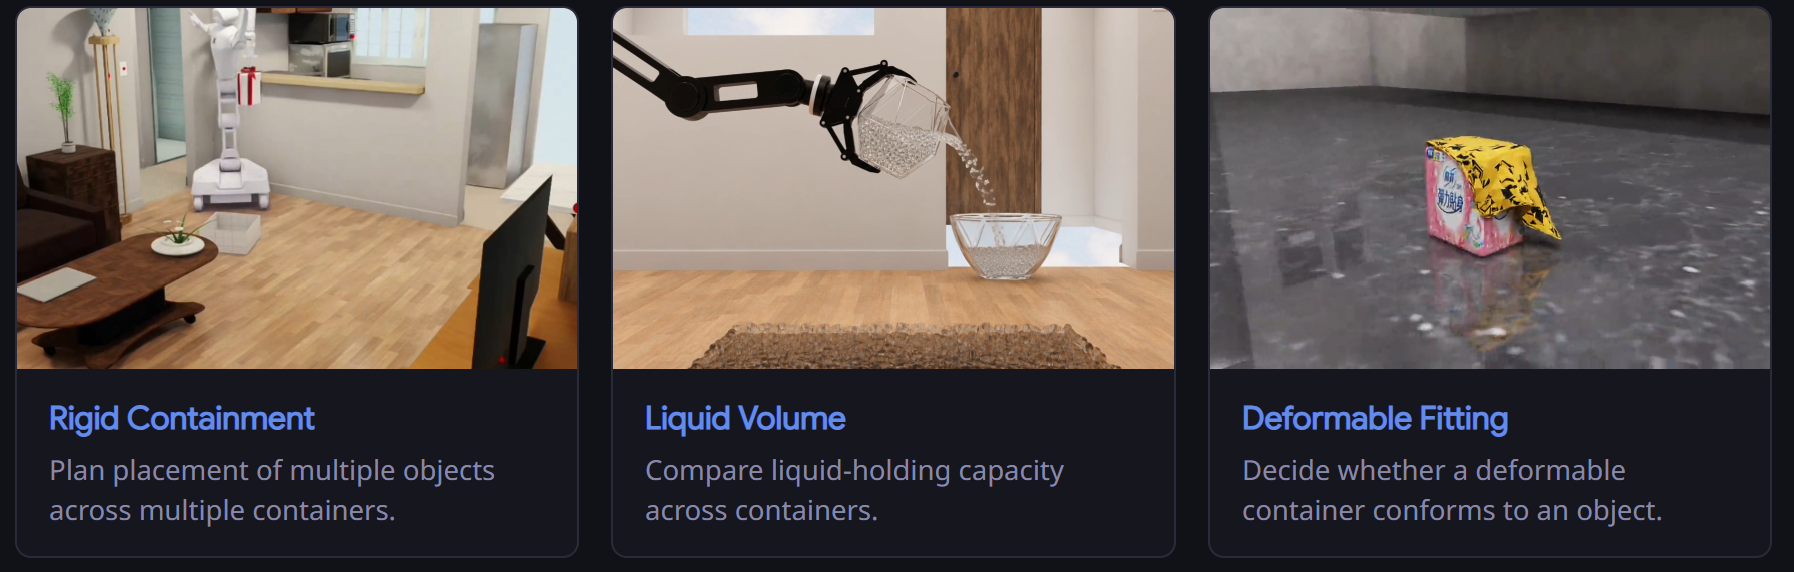
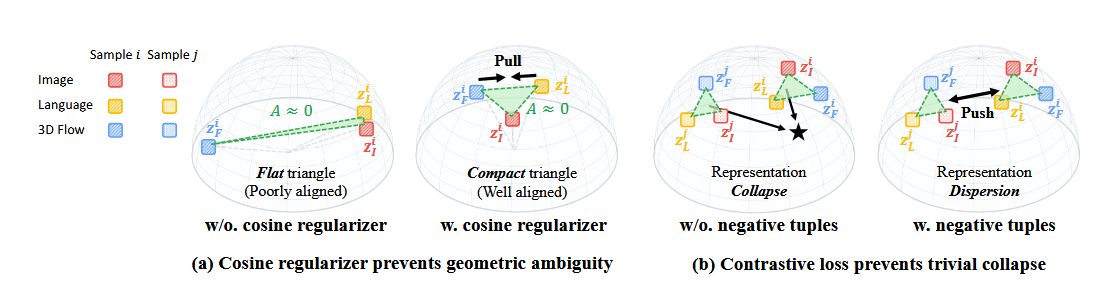
<div><div><h3 id="前言">前言</h3><p>传送门：</p><p><a href="https://esi-bench.github.io/">具身bench-mark  ESI-Bench</a></p><p><a href="https://dynaflip-robotics.github.io/">三模态动力学 DynaFLIP</a></p><h3 id="esi-bench">ESI-Bench</h3><p>要想学习，先要明白试卷的考题，对于科研而言，自然是先学习其bench mark了。</p><p>李飞飞教母的，嗯，，应该算比较新的，直接拿来看和对比其他的Bench了。</p><p>ESI-BENCH，这是一个涵盖10个任务类别和29个子类别的具身空间智能基准测试，共计3081个实例，基于 OmniGibson 的仿真平台，基于Spelke的核心知识系统。</p><p>论文的核心是提出 <strong>“行动失明”“元认知缺陷”</strong>。当然，前面基准也是弥补过去强调机器人感知而非主观性的原因。</p><p>用很多其他博客的话来说就是能不能会动、会摸、会主动找答案，而非单纯地看图。</p><p>而后者元认知缺陷，用论文的话来说，就是与寻求证伪观点并在矛盾中修正信念的人类不同，模型往往过早且信心十足，无论证据质量如何，暴露出一个元认知鸿沟，单靠更好的感知和更具身体化的互动无法弥合。</p><p>存一下找到的别人比较通俗的解说：<a href="https://www.aitntnews.com/newDetail.html?newId=25384">https://www.aitntnews.com/newDetail.html?newId=25384</a></p><p>换句话来说，其他的benchmark相当于被动型的基准，而这一篇则是主动型的基准。</p><p>论文贴心地给各个bench分了类，正好我懒得找。</p><p><img alt="屏幕截图 2026-08-31 180818.png" src="https://s3.bmp.ovh/2026/08/31/P02Zw776.png"/></p><h4 id="被动型基准">被动型基准</h4><p>论文里面简述了4大个：  <strong>VSR, BLINK, 3DSRBench，VSI-Bench</strong></p><p>分别是单图的空间推理，多模态（空间，光流，视觉推理混合）感知，3D空间推理，视觉场景理解等。这些基准来说，模型是无需与场景进行交互的。</p><p>关于测评，每一个基准都要有一个交互和仿真的平台。贴一下：</p><table><thead><tr><th>平台</th><th>用途</th><th>代表基准</th></tr></thead><tbody><tr><td>OmniGibson / iGibson</td><td>室内操作+导航</td><td>ESI-Bench</td></tr><tr><td>Habitat / Habitat-Matterport</td><td>3D导航</td><td>Habitat Challenge</td></tr><tr><td>MuJoCo</td><td>全身控制</td><td>HumanoidBench</td></tr><tr><td>BEHAVIOR-1K</td><td>长时家庭操作</td><td>BEHAVIOR</td></tr><tr><td>RoboSuite / Gymnasium</td><td>机器人操作</td><td>Robosuite</td></tr></tbody></table><p>拿Omnigibson举例子：</p><p>OmniGibson 基于 NVIDIA Isaac Sim 和 PhysX 5，支持通过刚体接触物理、粒子流体、透明渲染、真实光照和反射，以及填充和切换状态等扩展对象状态实现具象空间评估。</p><p>关于搭建也很简单</p><pre><code class="lang-bash">
# 一、OmniGibson 搭建（Linux）
# 1. 环境：Ubuntu + CUDA + conda
# 2. 安装：
   conda create -n omnigibson python=3.8
   conda activate omnigibson
   pip install omnigibson
   # 首次运行下载约 5GB 资源
# 3. 验证：
python -c &quot;import omnigibson&quot;</code></pre><p>评价流程
1. 加载场景+任务（BEHAVIOR-1K）
2. 定义 policy 接口：
   def act(obs) -&gt; action
   obs={rgb, proprio, task}
   action={decision, control}
3. 闭环：act -&gt; 仿真执行 -&gt; 新obs，循环
4. 记录：正确率 + 步数
5. 对照：主动 vs 随机 vs oracle</p><p>对于基准来说基本上都是接收传感器输入和机器人当前的状态输入，高层输出决策，底层小脑输出运动控制。模型可以看懂图片就可以</p><h4 id="主动基准">主动基准</h4><p>ESI的官网给了很鲜明的三个例子。</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/08/31/UrVtChW1.png"/></p><p>分别是刚性容纳、液体体积、物体遮挡。</p><p>「刚性容纳」题：给定几个容器和几个物体，要求把物体全部装进去。有的容器开口小、有的内部有隔板、有的盖子需要掀开才能看到真实容量</p><p>「液体体积」题：两个杯子，从外观看不出容量差异，模型需要把水倒进去测试，或者直接拿起来掂量。</p><p>对于ESI来说，模型的任务多了很多探索和试错，而非依赖先验知识。</p><p>我的理解是更强调方法论的智能体，比知识堆砌智能体更为重要，也符合我对AGI的评判。</p><p>值得关注点如遮挡题目——</p><p>Gemini 3.1在「部分遮挡」任务上，如果给到最佳观察视角，准确率从14.6%暴涨到95.1%。证明对于EAI来说，遮挡是一个很大的误差因素。</p><p>而其评测中，被动多视角策略不仅没用，反而有害。让GPT-5多看几张随机角度的图片，空间距离任务的准确率从53.9%降到49.1%。李飞飞团队将其称为动作盲视。差的动作带来差的视角，差的视角进一步引发差的动作（前提：模型自身总是对自己的先验判读过于自信——元认知缺陷：模型不知道自己看没看够）。也对比人类行为，总是会怀疑判断然后直接去试错。可以说这个bench确实切入了当前模型的一些弊病和痛点。</p><p>贴一下这个比较重要的对比：也是主动和被动任务来说机器和人的差距体现。</p><p>在真实轨迹条件下，Gemini在部分遮挡任务上达到88.4%的准确率，而人类为87.4%；GPT-5在材质透明度任务上达到96.3%，人类则为97.2%。</p><p>在物理接触任务中，人类准确率为88.3%，而 GPT-5仅为 64.2%；在材质透明度任务中，人类准确率为93.6%，Gemini 3.1则为52.3%。</p><p>不过吐槽一下人类准确度怎么这么低的，美国请的啥人去测的。</p><h4 id="esi-bench">ESI-bench</h4><p>这里单独讲解一下ESI-bench的测评基准。虽然前面主动基准来说当前也就这个，不过未来肯定会有更多的基准的。</p><p><strong>任务定义</strong>：</p><p>ESI-Bench 中的每个任务定义为元组（S， p0， q， y∗），其中 S 是从 BEHAVIOR-1K 场景池中实现的 3D 场景，包含预加载对象，p0 是代理的初始姿态，q 是关于场景空间属性的自然语言问题，y ∗ 是真实答案。将环境形式化为E = ⟨S， A， O， T ⟩，其中A为动作空间，O为以自我为中心的观察空间，T ： S × A → S主导场景转换。给定 （S， p0， q），智能体在每个时间步接收 ∈ O 的观察值，在 ∈ A 处执行动作，并诱导轨迹 τ = （o0， a0， o1， a1， ... .），直到在 Tmax = 30 步的预算内承诺最终答案 yˆ;</p><p>在OmniGibson模拟器中的BEHAVIOR-1K上构建ESI-BENCH。BEHAVIOR-1K 提供 51 个交互式 3D 场景，涵盖住宅、商业和机构环境，总计超过 300 个房间和 9000 个物体实例，涵盖 1,829 个类别，具备摩擦、质量和可动性等物理属性。</p><p>到这里顺便吐槽一下，自己记录到这里发现测试的基本上都是MLLM+agent的范式。</p><p>这里也引出一下查到的当前具身算法的主要流派：</p><ol start="1"><li><p>MLLM+agent；</p></li><li><p>专用具身模型；</p></li><li><p>MLLM高层大脑+底层动作设计；</p></li></ol><p>所以这个文章也是单独设计好了语言模型的的流程。也方便各个MLLM在同一的尺度下比较。</p><p>贴一下其他适合给pi0.5这类算法（第二三类）的bench，码上以后再读。</p><pre><code class="lang-txt">
VLA 评估 Benchmark 清单（适合 π0.5 类融合算法）
====================================================

一、操作/操纵（低层控制）
- RoboColiseum
  https://github.com/robocoliseum
  说明：内置 π0/π0.5/GR00T 基线，30分钟评测，四维度（指令/空间/扰动/通用）
- LIBERO
  https://github.com/Lifelong-Robot-Learning/LIBERO
- SIMPLER
  https://github.com/simpler-env/SimplerEnv
- BEHAVIOR-1K
  https://github.com/StanfordVL/behavior-1k

二、移动操作/人形（Loco-manipulation）
- HumanoidBench
  https://github.com/carlosferrazza/humanoid-bench
  说明：已收录（C30）
- SIMPLE
  https://github.com/ubc-systopia/SIMPLE
  说明：已收录（C34）
- NAVSIM
  https://github.com/autonomousvision/navsim

三、跨本体/多任务
- Open X-Embodiment
  https://github.com/google-deepmind/open_x_embodiment

四、推理/决策（辅助高层）
- ESI-Bench
  https://github.com/omarray/esi-bench
  说明：仅辅助测高层推理，不适合测低层动作

建议用法：
- 低层动作：LIBERO / SIMPLER
- 系统融合：RoboColiseum（可和 π0.5 公平对比）
- 跨本体：Open X-Embodiment
- 人形全身：HumanoidBench / SIMPLE</code></pre><hr/><h3 id="动态感知与理解">动态感知与理解</h3><p>接下来是 DynaFLIP 这篇，依旧AI帮我筛选然后开盲盒。</p><p>但看算法定位的话，是那种可以复用的感知前端头，应该可以作为pi0.5那种的前端视觉backbone部分。</p><p>正常我们之前做三维感知的话处理的数据大都是点云，栅格，或者说现在的OCC。这篇提出来的三个模态分别是（VLO）图像，语言，3D光流。</p><p>先拆解一下比较陌生的3D光流：</p><p>类似图像的光流，3D光流是三维的向量组，可以表征点云等三维表征的变化情况（运动轨迹）。</p><p>具体来说：时间t到t+k的三维光流场 $ F_{t:t+k} $ ，也就是稠密的3D场景运动矢量场。来源于深度信息和点云+跨帧匹配得到的场景流（不过我怀疑还是算不上稠密，如果是RGBD做的也可以压缩到二维数据的样子（投影的话））</p><p>不过在这个文章里面这个3D光流主要用于训练时期的监督，而非输入。所以其核心提升点自然也跃然纸上了。。（数据增强与额外监督工程）</p><h4 id="方法论">方法论</h4><p>三模态三元组：(图像过渡, 语言, 3D光流)</p><p>图像转换捕捉视觉状态变化，语言在语义层面指定预期过渡，三维流编码场景中的物理运动。</p><p>模态 | 编码 | 捕捉什么
图像过渡 | DINOv2（全微调）| 视觉状态变化（I_t 到 I_t+H）
语言 | 冻结T5 + adapter | 语义意图（&quot;把叉子放毛巾上&quot;）
3D光流 | 3D flow encoder | 场景物理运动轨迹</p><p>核心机制：Simplex Volume Minimization
- 三模态 embedding 投影到共享超球面空间（ℓ2归一化）
- 三点形成三角形（simplex）
- 目标：最小化三角形面积 → 面积越小对齐越强</p><p>解决两个陷阱：
1. 几何歧义：面积小不等于真对齐
2. 平凡坍缩：最小化=三点塌缩到一点（无用）</p><p>解决：simpleX面积最小化 + cosine正则 + 对比学习</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/01/q2SOnZTH.png"/></p><p>以这个图为例子，核心的目标是对齐三个模态。而对齐其的损失相当于这个三角形的面积，而对于这个面积有一个优化误区就是其中两个模态靠得足够接近，则面积也约等于0，故需要施加惩罚所以引入了这个cosine正则化。</p><pre><code>E(zL, zI , zF ) = A(zL, zI , zF ) − α⟨zL, zF ⟩,</code></pre><p>这里面的zL, zI , zF 就分别表征语言图像光流三个模态的向量，A后面计算这三个向量围成的面积，α后面跟着的向量余弦乘积就是用于平衡这个惩罚的（防止出现单一超远距离的向量）余弦项明确将zL和zF拉到一起（虽然不知道为什么是单独把L和F这两个模态拉一起，不过一般来说，L和F这两个语言和光流本身就容易模态跑很远，优先拉近是没问题的）。</p><p>用论文的话来说：多种模态对齐的常用策略是基于锚点的对比学习，其中一个模态作为参考，每个辅助模态独立对齐该模态。然而，该设计仅强制对锚两两对齐，不约束非锚模态之间的相对关系。为了捕捉三种模态之间的相互对齐，其采用基于单纯形体积的表述 。对于m模态组的L2归一化嵌入，广义单纯形体积Vm衡量嵌入在共享潜空间中所张成的单纯形体积，较小的Ω表示关节对齐更强。</p><p>顺便复习一下l2归一化：就是将向量除以其 L2 范数，使其长度变为 1，仅保留方向信息，例如向量 [3,4] 归一化后变为 [0.6,0.8]。</p><p>这也是为什么这些模态会在一个球面上（单位为1的球。当然，这个球是一个超球面，向量的维度肯定不止3维）</p><p>还有一个，对于前后两次采样，防止全部摆烂归一到同一个点上，也会坍缩（因为对于不同的采样，我希望模态对齐（面积足够小），同时希望不同采样之间在超球面上是有区分的）。通过在批次中错配一个或多个模态嵌入，构造一组负元组N（i）在下面的损失式子，强迫这个E(zL, zI , zF )区分要足够高。</p><p><img alt="image.png" src="https://s3.bmp.ovh/2026/09/01/jvbWv3zi.png"/></p><p>这里的公式就类似对比学习的思想，对于这些故意错配的N（i）,需要使得这些E与其区分足够大，才能减小这个Loss。</p><p>至于为什么是这些指数公式，多半是工程经验了。</p><p>这个类似的公式还用于后续的时序对比损失等等，用于捕捉动态帧的信息。</p><p>辅助目标：时序对比损失 + actor损失</p><p>关键：3D 光流是训练期监督，不是推理期输入。</p><p>训练时：
图像过渡 ✕ 语言 ✕ 3D光流 → 三模态对齐 → 训练图像 encoder</p><p>推理时（downstream）：
只用图像 encoder 做视觉 backbone，3D 光流和语言都不需要</p><p>融合方式：
1. 图像 encoder 从 I_t/I_t+H 提取 → z_I
2. T5 adapter 从语言取 EOS token → z_L
3. 3D flow encoder 从 F_{t:t+K} → z_F
4. 优化：最小化 z_I/z_L/z_F 张成的三角形面积</p><p>用途：
- 语言给不了精确物理
- 图像过渡给不了连续运动轨迹
- 3D 光流补足：精确接触/形变/真实位移轨迹</p><p>总体来说很优秀的处理思想，提点不少。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/embody-ai/dyana-esi#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>Codex 在 SSH Remote 场景下登录 403 （ Country, region, or territory not supported） 问题留档</title>
            <link href='https://www.sorodo.xyz/posts/default/codex403'/>
            <id>https://www.sorodo.xyz/posts/default/codex403</id>
            <published>2026-06-11T07:10:01.642Z</published>
            <updated>null</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/default/codex403'>https://www.sorodo.xyz/posts/default/codex403</a></blockquote>
<div><div><h2 id="背景">背景</h2><p>这次遇到的问题表面上很简单：在 Windsurf 里登录 Codex 插件时，反复报错：</p><p><code>Token exchange failed: token endpoint returned status 403 Forbidden: Country, region, or territory not supported</code></p><p>但实际排查下来，这不是一个单点问题，而是一个典型的 <strong>SSH Remote + 浏览器登录 + 远端 token exchange + 代理出口风控</strong> 叠加问题。</p><p>本文记录一次完整排障过程，重点回答四个问题：</p><ol start="1"><li>Windsurf / Codex 在 SSH Remote 下的登录流程到底是什么。</li><li>为什么“浏览器能打开登录页”并不等于“最终一定能登录成功”。</li><li>为什么修改远端机器的 <code>.bashrc</code> 这类配置有时真的会生效。</li><li>这次问题的根因、有效做法、以及后续可复用的排查思路是什么。</li></ol><hr/><h2 id="现象">现象</h2><p>登录 Codex 时，Windsurf 日志中反复出现：</p><ul><li><code>TypeError: fetch failed</code></li><li><code>oauth token exchange returned non-success status status=403 Forbidden</code></li><li><code>unsupported_country_region_territory</code></li></ul><p>关键日志位于：</p><ul><li><code>~/.windsurf-server/data/logs/20260611T120845/exthost2/openai.chatgpt/Codex.log</code></li><li><code>~/.windsurf-server/data/logs/20260611T120845/exthost4/openai.chatgpt/Codex.log</code></li></ul><p>后续多次重试后，最新一轮仍然是同样的失败点：</p><ul><li>浏览器登录流程走到了 callback</li><li>但 <strong>token exchange</strong> 阶段仍然返回 <code>403 Forbidden</code></li><li>错误码为 <code>unsupported_country_region_territory</code></li></ul><p>说明问题是 <strong>服务端对当前出口 IP / 区域 / 风险特征做了拒绝</strong>。</p><hr/><h2 id="一、ssh-remote-下的实际登录链路">一、SSH Remote 下的实际登录链路</h2><p>排查中可以确认：</p><ul><li>Windsurf 的远端扩展宿主进程运行在 <strong>远端机器</strong> 上</li><li>远端环境里存在 <code>BROWSER=.../helpers/browser.sh</code></li><li>这个 <code>browser.sh</code> 实际调用的是 <code>server-cli.js --openExternal</code></li></ul><p>表明：</p><ol start="1"><li><strong>打开浏览器</strong> 这个动作，会被从远端请求转发到客户端侧执行</li><li>但很多真正的网络请求，尤其是 <strong>Codex / ChatGPT 相关的 token exchange</strong>，仍然发生在 <strong>远端进程</strong> 中</li></ol><p>换句话说，这个流程至少分成两段：</p><h3 id="1.-浏览器阶段">1. 浏览器阶段</h3><ul><li>本地浏览器打开登录页</li><li>用户完成账号登录</li><li>页面回调回 Windsurf / Codex</li></ul><h3 id="2.-ide-/-远端服务阶段">2. IDE / 远端服务阶段</h3><ul><li>远端 Windsurf / Codex 进程继续完成 token exchange</li><li>与 <code>chatgpt.com</code>、<code>ab.chatgpt.com</code>、插件同步接口等发生通信</li></ul><p>这就是为什么：</p><ul><li><strong>本地浏览器代理</strong> 可能影响登录页是否正常打开</li><li><strong>远端代理环境</strong> 又会影响最终 token exchange 是否成功</li></ul><p>如果只改其中一边，另一边仍然可能失败。</p><hr/><h2 id="二、以前改浏览器代理曾经成功">二、以前改浏览器代理曾经成功</h2><p>之前遇到过类似问题，而且通过“改浏览器代理”解决过。这个经验并不矛盾，反而很关键。</p><p>它通常对应两种可能：</p><h3 id="1.-当时失败点主要发生在浏览器侧">1. 当时失败点主要发生在浏览器侧</h3><p>例如：</p><ul><li>浏览器没有走系统代理</li><li>浏览器插件指定了一个更干净的节点</li><li>登录页本身被地区 / 风控拦截</li></ul><p>这种情况下，只改浏览器代理，确实可能直接解决问题。</p><h3 id="2.-浏览器和-ide-当时碰巧走到了同一个可用出口">2. 浏览器和 IDE 当时碰巧走到了同一个可用出口</h3><p>即使 Windsurf / Codex 的后续 token exchange 在远端执行，只要：</p><ul><li>浏览器出口够干净</li><li>远端出口也足够干净</li><li>或两边实际落到同一类可用出口</li></ul><p>也可能顺利成功。</p><p>但这一次情况不同：</p><ul><li>浏览器链路不一定是唯一问题</li><li>远端进程本身也明确参与 token exchange</li><li>远端实际出口质量很差</li></ul><p>所以只改浏览器代理，未必能再复现之前的成功。</p><hr/><h2 id="三、这次排查出的几个关键事实">三、这次排查出的几个关键事实</h2><h3 id="1.-日志失败点始终一致">1. 日志失败点始终一致</h3><p>无论重试多少次，核心错误都没有变：</p><ul><li><code>unsupported_country_region_territory</code></li><li><code>Token exchange failed</code></li></ul><p>这说明不是一次性的偶发异常，而是稳定的环境问题。</p><h3 id="2.-远端-windsurf-进程没有真正继承代理环境">2. 远端 Windsurf 进程没有真正继承代理环境</h3><p>这是本次排查最重要的发现之一。</p><p>虽然已经做过：</p><ul><li><code>http.proxy</code></li><li><code>http.proxySupport</code></li><li>远端 <code>.bashrc</code> 中加入 <code>http_proxy / https_proxy / all_proxy</code></li><li><code>remote.windsurfSSH.httpProxy</code></li><li><code>remote.windsurfSSH.httpsProxy</code></li></ul><p>但真正查看远端 <code>extensionHost</code> 和其父进程环境时，仍然发现：</p><ul><li>没有 <code>http_proxy</code></li><li>没有 <code>https_proxy</code></li><li>没有 <code>all_proxy</code></li></ul><p>同时还能看到：</p><ul><li><code>--useHostProxy=false</code></li></ul><p>这说明：</p><ul><li>远端进程的启动链路并没有可靠继承 shell 中的代理导出</li><li>即使设置文件已经写入，也不代表当前在跑的远端 server 一定已经重新加载</li></ul><h3 id="3.-“重启登录”并不等于远端-server-被真正重启">3. “重启登录”并不等于远端 server 被真正重启</h3><p>进一步查看进程树发现：</p><ul><li>新的 <code>extensionHost</code> 是后来重新拉起的</li><li>但远端 <code>windsurf-server</code> 的父进程其实还是 <strong>12:08 启动的老进程</strong></li></ul><p>这说明很多看起来像“已经重启”的操作，实际上只是：</p><ul><li>重启了部分子进程</li><li>或重新打开了登录流程</li><li>但没有让远端 server 主进程按新环境重新启动</li></ul><p>只要这个老父进程还在，后续子进程就很可能继续继承旧环境。</p><hr/><h2 id="四、为什么改远端-`.bashrc`-有时有效">四、为什么改远端 <code>.bashrc</code> 有时有效</h2><p>以前改.bashrc成功过。</p><p>有些人会说：</p><blockquote><p>浏览器明明在本地开，为什么改远端 <code>.bashrc</code> 会有用？</p></blockquote><p>答案是：</p><ul><li><strong>打开浏览器</strong> 不等于 <strong>所有登录相关请求都在本地执行</strong></li><li>SSH Remote 场景下，远端 Windsurf / Codex 进程仍然负责一部分关键请求</li><li>只要这些请求发生在远端，它们就会受到远端环境变量、远端 server 启动参数、远端代理设置的影响</li></ul><p>所以改远端 <code>.bashrc</code> 并不是“玄学”，而是可能确实影响：</p><ul><li>远端 extension host</li><li>远端 app-server</li><li>远端插件同步</li><li>远端 token exchange</li></ul><p>不过前提是：</p><ul><li>这些变量真的被启动链路继承到了</li><li>对应进程也确实被重新拉起</li></ul><p>如果只是改了 <code>.bashrc</code>，但老 server 没退出，那就可能“看起来改了，实际没生效”。</p><hr/><h2 id="五、修正">五、修正</h2><h3 id="1.-在远端-windsurf-用户设置中手动指定代理">1. 在远端 Windsurf 用户设置中手动指定代理</h3><p>修改：</p><ul><li><code>~/.windsurf-server/data/User/settings.json</code></li></ul><p>内容包括：</p><pre><code class="lang-json">{
  &quot;http.proxy&quot;: &quot;http://127.0.0.1:7897&quot;,
  &quot;http.proxySupport&quot;: &quot;override&quot;,
  &quot;remote.windsurfSSH.httpProxy&quot;: &quot;http://127.0.0.1:7897&quot;,
  &quot;remote.windsurfSSH.httpsProxy&quot;: &quot;http://127.0.0.1:7897&quot;
}</code></pre><h3 id="2.-在远端-`.bashrc`-中导出代理环境变量">2. 在远端 <code>.bashrc</code> 中导出代理环境变量</h3><p>加入了：</p><ul><li><code>http_proxy</code></li><li><code>https_proxy</code></li><li><code>all_proxy</code></li><li><code>HTTP_PROXY</code></li><li><code>HTTPS_PROXY</code></li><li><code>ALL_PROXY</code></li><li><code>no_proxy</code></li><li><code>NO_PROXY</code></li></ul><p>而且特意放在了 <code>.bashrc</code> 里“非交互 shell 提前 return”之前。</p><h3 id="3.-修改远端-`windsurf-server`-启动脚本">3. 修改远端 <code>windsurf-server</code> 启动脚本</h3><p>进一步将代理导出直接写入：</p><ul><li><code>~/.windsurf-server/bin/&lt;commit&gt;/bin/windsurf-server</code></li></ul><p>目的是绕开 shell 继承不稳定的问题，让后续 server 主进程和其子进程在启动时显式拥有代理环境。</p><h3 id="4.-切换默认浏览器到-chromium">4. 切换默认浏览器到 Chromium</h3><p>因为本地发现：</p><ul><li><code>Chromium</code> 没有单独代理扩展</li><li>没有额外 <code>proxy</code> 配置</li><li>比一个配置不明确的 Firefox 环境更容易和系统代理保持一致</li></ul><p>这个操作的目标是减少：</p><ul><li>本地浏览器出口</li><li>远端 Windsurf 登录链路</li></ul><p>之间的不一致性。</p><hr/><h2 id="六、若问题仍然没有消失">六、若问题仍然没有消失</h2><p>到这里还没有最终彻底登录成功，原因主要有两个：</p><h3 id="1.-远端老-server-仍未被完全重启">1. 远端老 server 仍未被完全重启</h3><p>虽然配置和脚本都改了，但运行中的老 <code>windsurf-server</code> 进程没有完全退出并重启。</p><p>因此：</p><ul><li>新配置可能尚未真正进入生效态</li><li>新的 <code>extensionHost</code> 仍可能被老父进程按旧环境拉起</li></ul><h3 id="2.-即使代理生效，当前代理出口本身仍可能不够干净">2. 即使代理生效，当前代理出口本身仍可能不够干净</h3><p>从前面的节点测试可知，这批节点大概率共享同类高风险机房出口。</p><p>所以最终问题很可能是 <strong>双重叠加</strong>：</p><ul><li>一方面，远端代理链路没有完全正确注入</li><li>另一方面，现有代理出口本身也可能已被风控 / 地域限制命中</li></ul><p>也就是说，这不是一个“只改一处就一定成功”的问题。</p><hr/><h2 id="七、最终根因总结">七、最终根因总结</h2><p>如果要用一句话概括这次问题，可以写成：</p><blockquote><p>这是一个由 <strong>SSH Remote 登录链路分裂</strong>、<strong>远端代理继承不稳定</strong>、以及 <strong>代理出口本身被风控/地域限制</strong> 共同导致的登录失败问题。</p></blockquote><p>更细一点，可以拆成三条：</p><h3 id="根因-1：登录流程并非纯本地">根因 1：登录流程并非纯本地</h3><ul><li>浏览器可能在本地打开</li><li>但 token exchange 明确发生在远端进程</li><li>因此不能只看本地浏览器代理</li></ul><h3 id="根因-2：远端代理配置没有真正进入运行中的-server-进程">根因 2：远端代理配置没有真正进入运行中的 server 进程</h3><ul><li>改了 <code>.bashrc</code></li><li>改了 <code>settings.json</code></li><li>但老 <code>windsurf-server</code> 没彻底退出</li><li>导致新配置没有完全被真正运行的父进程继承</li></ul><h3 id="根因-3：当前-clash-节点出口质量差">根因 3：当前 Clash 节点出口质量差</h3><ul><li>多个节点实际共用同类洛杉矶机房出口</li><li><code>hosting: true</code></li><li>这类出口更容易触发 OpenAI / ChatGPT / Codex 的地区与风控限制</li></ul><hr/><h2 id="经验">经验</h2><p>这次最有价值的经验不是“把某个开关打开了”，而是下面这句话：</p><blockquote><p>在 SSH Remote 场景下，任何涉及 OAuth / 浏览器回调 / token exchange 的问题，都应该默认按“本地 + 远端双端排查”来处理。</p></blockquote><p>只排本地，容易漏掉远端 token exchange。</p><p>只排远端，又容易忽略浏览器实际打开位置和本地代理扩展。</p><p>而如果代理出口本身质量差，那么即使两边都配对了，最终也仍然可能被服务端 403。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/default/codex403#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>Tailscale远程配置</title>
            <link href='https://www.sorodo.xyz/posts/Ref-utils/tailscale'/>
            <id>https://www.sorodo.xyz/posts/Ref-utils/tailscale</id>
            <published>2026-04-17T02:41:10.239Z</published>
            <updated>2026-04-28T06:50:22.161Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/Ref-utils/tailscale'>https://www.sorodo.xyz/posts/Ref-utils/tailscale</a></blockquote>
<div><div><h3 id="前言">前言</h3><p>为了防止公网暴露，最后还是放弃了反向ssh的方法。Tailscale一开始以为会延迟很高，但是在正确配置之后，也能实现低延迟的舒适ssh</p><p>应用场景：个人主机PC在家庭/内网等需要远程ssh连接的情况。</p><h3 id="tailscale安装&amp;使用">Tailscale安装&amp;使用</h3><p>没啥说的，巨简单</p><p><a href="https://tailscale.com/">https://tailscale.com/</a></p><h3 id="p2p">P2P</h3><p>正常走DERP默认国外的那几个服务器，在国内使用延迟会很高，如果不想自建DERP的话，优先打通P2P。</p><p>首先确认一下当前的主机是否支持P2P，(部分内网会拦截）。</p><pre><code class="lang-powershell">tailscale status

tailscale netcheck</code></pre><p>查看是不是有如下的：</p><p>UDP: true</p><p>MappingVariesByDestIP: false</p><p>IPv4: yes</p><p>IPv6: yes</p><p>尤其是对于其中的MappingVariesByDestIP，如果为true的话很可能你是在公司内网或者酒店网络等环境（hard NAT）。个人建议是换手机热点。</p><p>接下来放行防火墙。</p><p>对于Linux:</p><pre><code class="lang-bash">sudo ufw allow 41641/udp</code></pre><p>对于win: 注意是powershell不是cmd</p><pre><code class="lang-powershell">New-NetFirewallRule -DisplayName &quot;Tailscale UDP&quot; ` -Direction Inbound -Protocol UDP -LocalPort 41641 -Action Allow

New-NetFirewallRule -DisplayName &quot;Tailscale UDP OUT&quot; ` -Direction Outbound -Protocol UDP -LocalPort 41641 -Action Allow</code></pre><p>或者云服务器安全组：放行 UDP 41641</p><p>有必要重启一下tailscale。</p><pre><code class="lang-bash">sudo tailscale down
sudo tailscale up --reset</code></pre><p>最后可以直接测试是否打通</p><pre><code class="lang-bash">tailscale status
tailscale ping &lt;对端ip&gt;</code></pre><p>如果是pong ... via xx.xx.xx.xxx:xxxx in xxms 没有DERP等字样就是成了</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/Ref-utils/tailscale#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>github 自查指令表</title>
            <link href='https://www.sorodo.xyz/posts/default/git'/>
            <id>https://www.sorodo.xyz/posts/default/git</id>
            <published>2026-03-19T03:40:02.162Z</published>
            <updated>2026-04-20T03:37:50.062Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/default/git'>https://www.sorodo.xyz/posts/default/git</a></blockquote>
<div><div><h3 id="配置-git-环境">配置 Git 环境</h3><p>在每台主机上安装 Git
确保所有主机都已经安装了 Git。对于 Linux 和 macOS 用户可以通过包管理器安装，Windows 用户可以下载并安装 Git for Windows。</p><p>设置用户信息
在每台主机上设置你的用户名和邮箱地址：</p><pre><code class="lang-bash">git config --global user.name &quot;Your Name&quot;
git config --global user.email &quot;you@example.com&quot;</code></pre><p><strong>初始化或克隆仓库</strong></p><p>初始化新的仓库
如果你正在启动一个新的项目，可以在其中一台主机上初始化一个 Git 仓库：</p><pre><code class="lang-bash">cd your_project_directory
git init</code></pre><p><strong>克隆现有的仓库</strong>
如果要从 GitHub 或其他远程仓库开始工作，在任何主机上运行以下命令克隆仓库：</p><pre><code class="lang-bash">git clone https://github.com/yourusername/your-repo.git</code></pre><h3 id="**分支管理**"><strong>分支管理</strong></h3><h5 id="查看当前分支">查看当前分支</h5><p>查看所有本地分支，并标识出当前所在的分支：</p><pre><code class="lang-bash">git branch</code></pre><h5 id="创建新分支">创建新分支</h5><p>在任意主机上基于当前分支创建一个新分支：</p><pre><code class="lang-bash">git checkout -b new-branch-name
# 或者使用 Git 2.23+ 版本的 switch 命令 git switch -c new-branch-name</code></pre><h5 id="切换分支">切换分支</h5><p>切换到已存在的分支：</p><pre><code class="lang-bash">git checkout existing-branch-name
# 或者使用 Git 2.23+ 版本的 switch 命令 git switch existing-branch-name</code></pre><p>推送新分支至远程
当你在一个主机上创建了一个新分支，并希望将其推送到远程仓库时：</p><pre><code class="lang-bash">git push -u origin new-branch-name</code></pre><h4 id="同步与更新代码">同步与更新代码</h4><h5 id="拉取最新更改">拉取最新更改</h5><p>在进行任何更改之前，建议先拉取最新的更改以避免冲突：</p><p>本质等于 git fetch + git merge</p><pre><code class="lang-bash">git pull origin main</code></pre><h5 id="提交更改">提交更改</h5><p>完成修改后，添加文件到暂存区，然后提交：</p><pre><code class="lang-bash">git add .
git commit -m &quot;描述你的更改&quot;</code></pre><h5 id="推送更改">推送更改</h5><p>将本地的更改推送到远程仓库：</p><pre><code class="lang-bash">git push origin current-branch-name</code></pre><h4 id="处理冲突">处理冲突</h4><p>当多个主机对同一文件进行了不同的修改时，可能会发生冲突。解决步骤如下：</p><p>执行 git pull 时遇到冲突。
手动编辑冲突文件，选择保留哪些更改。
标记冲突为已解决：git add conflicted-file
完成合并：git commit</p><h4 id="分支合并">分支合并</h4><p>合并分支
假设你想把 feature 分支的工作合并到主分支中：</p><pre><code class="lang-bash">git checkout main
git merge feature</code></pre><h4 id="删除分支">删除分支</h4><h5 id="删除本地分支">删除本地分支</h5><p>一旦确认不再需要某个分支，可以删除它：</p><pre><code class="lang-bash">git branch -d branch-name</code></pre><h5 id="删除远程分支">删除远程分支</h5><p>如果你想从远程仓库中删除一个分支：</p><pre><code class="lang-bash">git push origin --delete branch-name</code></pre></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/default/git#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          <entry>
            <title>rtabmap手记</title>
            <link href='https://www.sorodo.xyz/posts/Ref-utils/rtabmap'/>
            <id>https://www.sorodo.xyz/posts/Ref-utils/rtabmap</id>
            <published>2026-03-11T06:25:23.736Z</published>
            <updated>2026-04-29T01:20:40.884Z</updated>
            <content type='html'><![CDATA[
              <blockquote>该渲染由 Kami API 生成，可能存在排版问题，最佳体验请前往：<a href='https://www.sorodo.xyz/posts/Ref-utils/rtabmap'>https://www.sorodo.xyz/posts/Ref-utils/rtabmap</a></blockquote>
<div><div><h2 id="前言">前言</h2><p>属实是SLAM里面最强大的后端。</p><h3 id="官方前端">官方前端</h3><p>在 rtabmap/corelib/include/rtabmap/core/Odometry.h 中定义了以下14 种前端类型：</p><p>默认可用的是0和1，其余的前端要单独选择编译。</p><pre><code class="lang-txt">0    F2M (Feature-to-Map)    视觉    RTAB-Map 自研的特征点法里程计
1    F2F (Feature-to-Feature)    视觉    RTAB-Map 自研的帧间特征匹配里程计（默认）
2    Fovis    视觉    基于直接法的视觉里程计
3    Viso2    视觉    基于特征的立体视觉里程计
4    DVO    视觉    密集视觉里程计
5    ORB-SLAM2/3    视觉    🌟 完整的 ORB-SLAM 系列
6    Okvis    VIO    紧耦合单目/立体视觉惯性里程计
7    LOAM    激光    经典激光雷达里程计
8    MSCKF    VIO    多状态约束卡尔曼滤波
9    VINS-Fusion    VIO    🌟 紧耦合 VIO+GPS 融合
10    OpenVINS    VIO    🌟 基于 ESKF 的多相机 VIO
11    FLOAM    激光    快速激光里程计
12    Open3D    视觉    Open3D 视觉里程计
13    CuVSLAM    视觉    GPU 加速的视觉 SLAM</code></pre><h3 id="rtabmap占据栅格图">rtabmap占据栅格图</h3><p>参考<a href="https://leiyiming.com/2016/10/27/rtabmap/">https://leiyiming.com/2016/10/27/rtabmap/</a></p><p>对于双目视觉，在ros2环境下，现在只需要设定raytracing即可。</p><h4 id="rtabmap建图参数">rtabmap建图参数</h4><table><thead><tr><th style="text-align:left">参数</th><th style="text-align:center">默认值</th><th style="text-align:left">说明</th></tr></thead><tbody><tr><td style="text-align:left">delete_db_on_start</td><td style="text-align:center">false</td><td style="text-align:left">启动时是否清空之前的建图数据，false为保留</td></tr><tr><td style="text-align:left">Grid/CellSize</td><td style="text-align:center">0.05</td><td style="text-align:left">栅格分辨率（米）</td></tr><tr><td style="text-align:left">Grid/MapFrameProjection</td><td style="text-align:center">false</td><td style="text-align:left">控制点云投影的坐标系：false为base_link坐标系，true为map坐标系</td></tr><tr><td style="text-align:left">Grid/Sensor</td><td style="text-align:center">1</td><td style="text-align:left">1表示从深度图创建栅格，0表示从激光扫描创建栅格</td></tr><tr><td style="text-align:left">Grid/3D</td><td style="text-align:center">true</td><td style="text-align:left">是否生成 3D 占用栅格</td></tr><tr><td style="text-align:left">Grid/MinGroundHeight</td><td style="text-align:center">0.0</td><td style="text-align:left">最小地面高度，低于此高度的点不被视为地面</td></tr><tr><td style="text-align:left">Grid/MaxGroundHeight</td><td style="text-align:center">0.0</td><td style="text-align:left">最大地面高度，高于此高度的点不被视为地面</td></tr><tr><td style="text-align:left">Grid/MaxObstacleHeight</td><td style="text-align:center">0.0</td><td style="text-align:left">最大障碍物高度，高于此高度的点不被视为障碍物</td></tr><tr><td style="text-align:left">Grid/NormalsSegmentation</td><td style="text-align:center">true</td><td style="text-align:left">true：使用基于法线的智能地面分割；false：使用简单的基于高度阈值的分割</td></tr><tr><td style="text-align:left">Grid/MaxGroundAngle</td><td style="text-align:center">45</td><td style="text-align:left">当 NormalsSegmentation=true 时，判断“地面”的法线角度阈值</td></tr></tbody></table><p>地图保存：</p><pre><code class="lang-bash">
ros2 run nav2_map_server map_saver_cli -f ~/SLAM/maps/mymap1 --ros-args -p map_topic:=/rtabmap/map

# or

 ros2 run nav2_map_server map_saver_cli -t /rtabmap/map -f ~/SLAM/maps/mymap1</code></pre><h3 id="深度学习描述子">深度学习描述子</h3><p>superpoint等深度学习描述子需要编译（需要torch），否则会默认找适用的描述子，如GFTT/ORB </p><pre><code class="lang-text">0=SURF 1=SIFT 2=ORB 3=FAST/FREAK 4=FAST/BRIEF 
5=GFTT/FREAK 6=GFTT/BRIEF 7=BRISK 8=GFTT/ORB 
9=KAZE 10=ORB-OCTREE 11=SuperPoint 12=SURF/FREAK 
13=GFTT/DAISY 14=SURF/DAISY 15=PyDetector 16=SuperPoint-Rpautrat</code></pre><h3 id="rtabmap-viz">rtabmap viz</h3><p>一键启动，但是功能堆多了很吃cpu，会卡卡的。</p><pre><code class="lang-bash">ros2 run rtabmap_viz rtabmap_viz</code></pre><h3 id="视觉和激光联合部分">视觉和激光联合部分</h3><p>Reg\Strategy=1 是 ICP，Reg\Force3DoF=true 会把约束压成 x, y, yaw，这正适合平面机器人 + 单线雷达。RTAB-Map 参数文档里 Reg/Strategy 的定义就是 0=Vis, 1=Icp, 2=VisIcp，Reg/Force3DoF 会把 z、roll、pitch 置零。</p><p>Grid\Sensor=0 表示 occupancy grid 从 laser scan 生成；Grid\ScanDecimation 是建栅格前对 laser scan 降采样。 Grid\CellSize=0.05 是 5 cm 栅格，CPU 紧张时可以改成 0.08 或 0.10。</p><p>Rtabmap\DetectionRate=1 表示 RTAB-Map 会按 1 Hz 处理输入图像；Mem\ImagePreDecimation 会在视觉特征检测前缩小图像；Kp\MaxFeatures 限制每帧提取特征数；Mem\LaserScanDownsampleStepSize 会在创建签名时降采样激光 scan。</p><p>Icp\Iterations、Icp\MaxCorrespondenceDistance、Icp\MaxTranslation、Icp\MaxRotation、Icp\CorrespondenceRatio 分别控制 ICP 最大迭代、点对应距离、可接受平移/旋转修正和匹配比例；Icp\PointToPlane=false 是因为单线 2D scan 的法向/平面约束不如 3D LiDAR 稳定，保守起步先用 point-to-point。</p><pre><code class="lang-ini">[Core]

; --------------------------
; 处理频率
; --------------------------
Rtabmap\DetectionRate=1
Rtabmap\ImageBufferSize=1
Rtabmap\TimeThr=300
Rtabmap\StatisticLogged=false

; --------------------------
; 内存/特征
; --------------------------
Mem\IncrementalMemory=true
Mem\ImagePreDecimation=2
Mem\LaserScanDownsampleStepSize=2
Kp\MaxFeatures=500

; --------------------------
; 图节点
; --------------------------
RGBD\Enabled=true
RGBD\CreateOccupancyGrid=true
RGBD\LinearUpdate=0.08
RGBD\AngularUpdate=0.08
RGBD\NeighborLinkRefining=true
RGBD\ProximityBySpace=true
RGBD\ProximityByTime=false
RGBD\ProximityPathMaxNeighbors=5
RGBD\LocalBundleOnLoopClosure=false

; --------------------------
; Visual + ICP
; --------------------------
Reg\Strategy=2
Reg\Force3DoF=true
Reg\RepeatOnce=true

; --------------------------
; 视觉约束门限
; --------------------------
Vis\MinInliers=20
Vis\PnPReprojError=3

; 如果是 stereo/RGB-D，通常可用 PnP / 3D约束；
; 如果是纯单目，谨慎尝试 Vis\EstimationType=2，但不要假设它能稳定提供尺度。
; Vis\EstimationType=1

; --------------------------
; ICP
; --------------------------
Icp\Strategy=0
Icp\PointToPlane=false
Icp\Iterations=15
Icp\MaxCorrespondenceDistance=0.10
Icp\CorrespondenceRatio=0.30
Icp\MaxTranslation=0.25
Icp\MaxRotation=0.30
Icp\RangeMin=0.10
Icp\RangeMax=8.0
Icp\VoxelSize=0.03

; --------------------------
; 栅格
; --------------------------
Grid\Sensor=0
Grid\CellSize=0.05
Grid\RangeMin=0.10
Grid\RangeMax=8.0
Grid\ScanDecimation=2
Grid\Scan2dUnknownSpaceFilled=false

Optimizer\Iterations=50</code></pre><p>如果是单目 + IMU + 单线雷达，谨慎地启用 Reg\Strategy=2。单目图像本身没有直接深度，单线雷达也不能给整幅图像特征点补深度，所以这时候 Visual+ICP 不是“视觉特征点和 scan 点直接合并”，而是注册/约束层面的组合。RTAB-Map 的参数里 Reg/Strategy=2 是 VisIcp，但视觉注册是否稳定取决于你的视觉输入形式。</p></div></div>
              <p style='text-align: right'>
              <a href='https://www.sorodo.xyz/posts/Ref-utils/rtabmap#comments'>看完了？说点什么呢</a>
              </p>
            ]]>
            </content>
            </entry>
          
    </feed>